Perakitan yang lebih cepat menyoroti pasokan memori
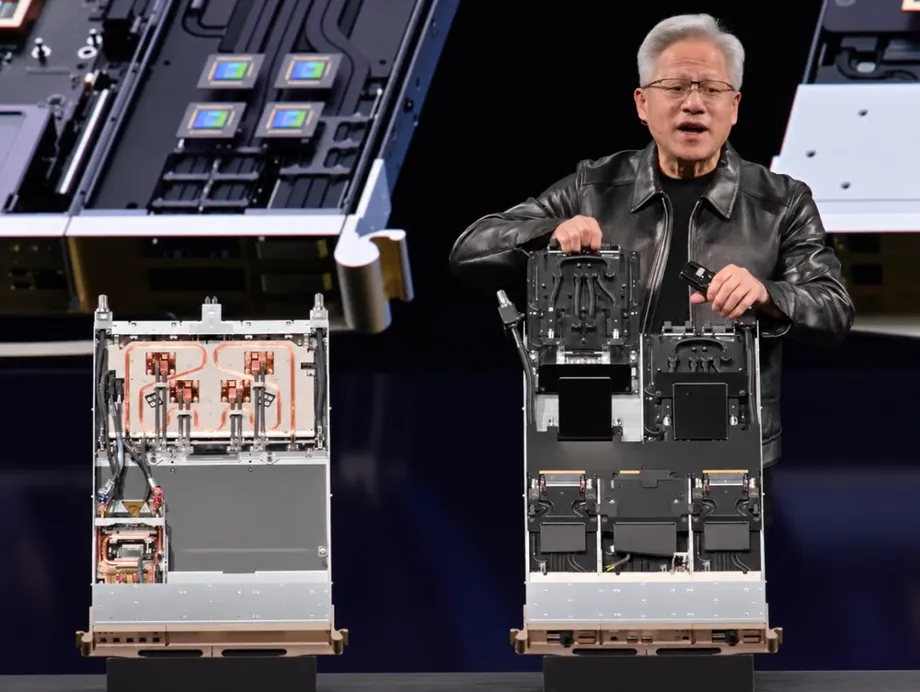
Nvidia telah memulai produksi penuh platform komputasi kecerdasan buatan Vera Rubin. CEO Jensen Huang mengatakan satu node server kini dapat dirakit dalam waktu kurang dari lima menit, dibandingkan dua jam untuk pendahulunya, Grace Blackwell. Perubahan ini menjanjikan produksi server yang lebih cepat sekaligus meningkatkan permintaan atas memori canggih yang dipasok Samsung Electronics, SK hynix, dan Micron.
Daftar Isi
- Perakitan yang lebih cepat menyoroti pasokan memori
- Apa yang berubah di dalam Vera Rubin?
- Mengapa HBM4 penting bagi kinerja AI
- Samsung mengejar kecepatan, SK hynix menambah kapasitas
- Micron memperluas produksi, kapasitas 2027 sudah dipesan
- Pengemasan dan tenaga kerja dapat membatasi pengiriman
- HBM4E sudah mulai dikembangkan
- Produsen melirik teknologi di luar memori yang berdampingan dengan GPU
- Tonggak produksi yang perlu dicermati
- Poin Penting
Huang memperkenalkan node Vera Rubin di GTC Berlin 2026. Ia menjelaskan bahwa desainnya tidak menggunakan kabel dan menerapkan pendinginan cair 100%. Grace Blackwell menggunakan pendinginan cair pada 80% sistem dan memerlukan proses perakitan yang jauh lebih rumit.
Perbandingan waktu perakitan itu menunjukkan pengurangan lebih dari 95,8%, dari 120 menit menjadi kurang dari lima menit. Bagi perusahaan yang membangun server AI dalam jumlah besar, penyederhanaan tahap ini dapat membantu mempercepat proses produksi di pabrik. Waktu yang dibutuhkan untuk memproduksi chip, mengemas memori, dan memasang sistem lengkap tetap menjadi bagian dari jadwal produksi secara keseluruhan.
Samsung dan SK hynix bersaing memperebutkan permintaan HBM4, memori bandwidth tinggi generasi keenam. Micron juga telah memperoleh kualifikasi untuk memasok Vera Rubin, sehingga persaingan ini melibatkan ketiga produsen HBM utama.
Pada saat yang sama, para pemasok sudah memperkenalkan HBM4E, generasi setelah HBM4. Pengumuman mereka menunjukkan dua tekanan yang saling terkait: Nvidia menginginkan server yang lebih mudah dirakit, sementara produsen memori harus menyediakan kecepatan dan kapasitas lebih tinggi melalui proses produksi yang rumit. Perakitan server yang lebih cepat membuat pengiriman chip yang andal semakin penting.
Apa yang berubah di dalam Vera Rubin?
Node server adalah salah satu unit penyusun sistem komputasi yang lebih besar. Nvidia menghubungkan unit-unit ini agar banyak prosesor dapat bekerja bersama untuk menangani tugas AI yang berat, seperti melatih model atau menjawab permintaan dari banyak pengguna.
Desain perakitan Vera Rubin yang lebih sederhana mengurangi pekerjaan untuk menghubungkan komponen. Perbandingan Huang dengan Grace Blackwell menyoroti penghilangan kabel dari node dan penerapan pendinginan cair secara menyeluruh.
Pendinginan cair mengalirkan panas dari komponen menggunakan cairan yang bersirkulasi. Prosesor AI yang bertenaga menghasilkan panas dalam jumlah besar, dan menjaga suhu tetap terkendali membantu prosesor bekerja dengan andal selama beban kerja berkelanjutan. Vera Rubin menerapkan pendekatan tersebut ke seluruh sistem yang dijelaskan Huang.
Pengumuman produksi Nvidia menandai dimulainya pembuatan desain ini. Kecepatan pengiriman sistem jadi kepada pelanggan juga bergantung pada ketersediaan prosesor, memori, kemasan, dan peralatan pendingin.
Mengapa HBM4 penting bagi kinerja AI
HBM menempatkan beberapa chip memori dalam tumpukan vertikal di samping prosesor AI. Sambungan-sambungan kecil yang menembus silikon memungkinkan data berpindah di antara lapisan. Sebuah permukaan penghubung mengaitkan tumpukan itu dengan prosesor sehingga prosesor dapat mengakses informasi dengan cepat.
Prosesor AI membutuhkan akses ini karena perhitungannya bergantung pada pasokan data yang konstan. Prosesor yang bertenaga dapat menghabiskan waktu menunggu jika memorinya tidak mampu mengirimkan informasi dengan cukup cepat. Bandwidth menggambarkan jumlah data yang dapat dipindahkan setiap detik, sedangkan kapasitas menunjukkan jumlah data yang dapat disimpan sekaligus.
HBM4 memperlebar antarmuka data menjadi 2.048 bit, dua kali lebar generasi sebelumnya. Samsung melaporkan bandwidth 2,8 terabita per detik untuk tumpukan 12 lapisnya, sementara Micron melaporkan lebih dari 2,8 terabita per detik untuk produk HBM4 yang saat ini ditawarkan.
Kecepatan dan kapasitas penyimpanan sama-sama penting. Pelatihan model AI memerlukan perhitungan berulang atas data dalam jumlah besar. Menjalankan model yang telah dilatih, yang dikenal sebagai inferensi, juga membutuhkan memori untuk menyimpan model dan informasi tentang permintaan yang sedang diproses.
Samsung mengejar kecepatan, SK hynix menambah kapasitas
HBM4 Samsung menggabungkan proses produksi DRAM 1c generasi keenam dengan base die yang dibuat menggunakan proses logika 4 nanometer. Base die adalah lapisan pengendali di bawah tumpukan memori. Samsung melaporkan kecepatan data 11,7 gigabit per detik pada setiap pin, yang dapat mencapai hingga 13 gigabit dalam konfigurasi yang dioptimalkan.
Hwang Sang-joon, kepala pengembangan memori Samsung Electronics, menjelaskan pilihan proses produksi tersebut saat perusahaan mengumumkan pengiriman komersial pertamanya:
Alih-alih menempuh jalur konvensional dengan memanfaatkan desain teruji yang sudah ada, Samsung mengambil langkah berani dengan mengadopsi teknologi proses tercanggih, seperti DRAM 1c dan proses logika 4 nm, untuk HBM4,
SK hynix mengambil pendekatan berbeda pada produk HBM4 yang dipamerkannya, dengan menggunakan proses DRAM 1b yang lebih mapan dan menumpuk 16 lapisan. Versi tersebut memiliki kapasitas 48 gigabita, dibandingkan 36 gigabita pada tumpukan 12 lapis Samsung.
Dengan demikian, tumpukan SK hynix memiliki kapasitas 12 gigabita lebih besar, atau naik sepertiga. Ruang tambahan itu dapat membantu sistem menyimpan lebih banyak informasi kerja di dekat prosesor. Pendekatan Samsung berfokus pada transfer yang lebih cepat dengan menggunakan proses produksi yang lebih baru.
Percakapan panjang dan tugas AI yang rumit membuat kapasitas sangat berharga. Model menyimpan informasi tentang bagian-bagian awal permintaan dalam penyimpanan sementara yang disebut cache key value. Ketika semakin banyak pengguna mengajukan permintaan yang lebih panjang, cache itu dapat memenuhi memori yang tersedia dan memaksa informasi dipindahkan ke penyimpanan yang lebih lambat.
Kepala pengembangan SK hynix, Ahn Hyeon, memperkirakan skala kinerja yang dibutuhkan infrastruktur AI pada 2030 bisa sekitar 20 kali lebih besar dibandingkan pada 2026. Argumennya untuk teknologi memori baru sebagian didasarkan pada meningkatnya jumlah informasi yang perlu tersedia dengan cepat bagi sistem inferensi.
Micron memperluas produksi, kapasitas 2027 sudah dipesan
Micron membuka fasilitas perakitan dan pengujian HBM canggih keduanya di Taichung, Taiwan, pada pertengahan Oktober 2026. Pabrik yang dikenal sebagai AATT2 itu menambah kapasitas untuk mengubah chip memori satuan menjadi tumpukan jadi.
Manish Bhatia, presiden sekaligus chief operating officer Micron, menggambarkan permintaan pada upacara pembukaan:
Seluruh kapasitas yang direncanakan untuk 2027 sudah habis terjual,
CEO Micron Sanjay Mehrotra mengatakan dalam paparan kinerja perusahaan pada Juni bahwa penjualan kumulatif HBM4 melampaui $1 miliar dalam beberapa bulan setelah pengiriman komersial dimulai. Ia juga mengatakan produksi HBM4 12 lapis meningkat dua kali lebih cepat dibandingkan peningkatan produksi HBM3E dengan konfigurasi setara.
Huang dari Nvidia mengonfirmasi pada Juni bahwa Samsung, SK hynix, dan Micron semuanya telah memperoleh kualifikasi HBM4 dan memulai produksi massal untuk Vera Rubin. Kualifikasi pelanggan berarti produk pemasok telah lolos pemeriksaan yang diperlukan agar dapat digunakan dalam sistem pelanggan.
Micron menargetkan kapasitas produksi HBM total sekitar 100.000 wafer per bulan pada akhir 2026. Hingga Juni, investasi kumulatifnya di Taiwan melampaui NT$1,6 triliun, atau sekitar $50,2 miliar.
Lokasi Tongluo milik perusahaan di Kabupaten Miaoli ditargetkan mulai mengirimkan produk secara penuh pada pertengahan 2027. Wafer dari lokasi itu akan menempuh perjalanan sekitar 24 kilometer ke AATT2 untuk dirakit dan diuji, menghubungkan dua tahap produksi dalam jarak yang relatif dekat.
Pengemasan dan tenaga kerja dapat membatasi pengiriman
Produksi HBM membutuhkan lebih dari sekadar membuat chip memori yang berfungsi. Produsen harus menipiskan silikon, membuat sambungan presisi yang menembusnya, lalu merekatkan beberapa lapisan. Kerusakan pada tahap-tahap ini dapat mengurangi jumlah tumpukan jadi yang layak digunakan.
Tumpukan yang lebih tinggi menambah jumlah sambungan dan proses perekatan yang harus berhasil. Karena itu, pilihan Samsung untuk menggunakan proses yang lebih baru dengan 12 lapisan dan penggunaan proses yang lebih mapan oleh SK hynix dengan 16 lapisan menghadirkan tantangan produksi yang berbeda, selain spesifikasi produk yang berbeda.
Pemasok peralatan Hanmi Semiconductor menyediakan mesin pengikat kompresi termal, yang menggunakan panas dan tekanan terkontrol secara cermat untuk menyatukan lapisan. SK hynix menandatangani kontrak senilai 44,2 miliar won, atau sekitar $33 juta, pada Juni untuk peralatan TC Bonder 4.5 Griffin yang telah ditingkatkan di fasilitasnya di Cheongju. Hanmi menjadwalkan peluncuran komersial Wide TC Bonder generasi berikutnya pada 2027.
Micron juga menghadapi ketidakpastian tenaga kerja di Taiwan. Serikat pekerjanya di Taoyuan melaporkan bahwa 1.994 dari 2.012 anggota yang memenuhi syarat menyetujui aksi mogok pada 7 Oktober, sekitar 99% dari anggota yang memenuhi syarat. Mediasi yang melibatkan serikat pekerja Taichung dijadwalkan pada 22 Oktober. Presiden Taiwan Lai Ching-te menghadiri pembukaan AATT2 dan mendesak semua pihak untuk bernegosiasi dengan itikad baik.
Perkembangan tersebut menyoroti pentingnya tenaga kerja selain peralatan pabrik. Persetujuan untuk melakukan mogok merupakan langkah yang membuka jalan bagi aksi industrial; belum ada pengumuman mengenai penghentian kerja atau gangguan pengiriman yang mungkin timbul.
HBM4E sudah mulai dikembangkan
Samsung dan SK hynix memamerkan teknologi HBM4E generasi berikutnya di SEDEX 2026, yang berlangsung pada 14-16 Oktober di COEX, Seoul. Keduanya juga memamerkan Vera Rubin Superchip milik Nvidia, yang menunjukkan eratnya hubungan antara persaingan memori dan platform Nvidia.
HBM4E Samsung menggunakan DRAM 1c dan base die yang dibuat dengan proses 4 nanometer. Samsung melaporkan kecepatan hingga 16 gigabit per detik per pin dan bandwidth 3,6 terabita per detik.
Dibandingkan bandwidth HBM4 Samsung yang disebut sebesar 2,8 terabita per detik, angka itu meningkat sekitar 29%. Tumpukan HBM4E 12 lapisnya memiliki kapasitas 48 gigabita, sepertiga lebih besar daripada kapasitas 36 gigabita pada tumpukan HBM4 dengan jumlah lapisan yang sama. Samsung juga berencana membuat versi delapan lapis berkapasitas 32 gigabita serta versi 16 lapis berkapasitas 64 gigabita.
SK hynix juga memperkenalkan HBM4E dengan kecepatan hingga 16 gigabit per detik per pin dan mengatakan efisiensi energinya akan meningkat lebih dari 20% dibandingkan HBM4. Samsung memberikan sampel kepada pelanggan pada Mei, sementara SK hynix mengirimkan sampel pada Juni untuk pemeriksaan kinerja. Samsung menargetkan produksi massal sesuai jadwal pelanggan.
Produsen melirik teknologi di luar memori yang berdampingan dengan GPU
Samsung memamerkan model zHBM, sebuah arsitektur yang menempatkan memori secara vertikal di atas chip komputasi, bukan di sampingnya. Jarak yang lebih pendek di antara keduanya dapat mengurangi waktu dan energi yang digunakan untuk memindahkan data.
SK hynix memperkenalkan flash bandwidth tinggi, atau HBF, yang diperkirakan menawarkan kapasitas sekitar 10 kali lebih besar daripada HBM yang ada. Teknologi yang diusulkan itu akan menambahkan satu lapisan antara memori cepat dan penyimpanan untuk membantu sistem AI mengelola data dalam jumlah lebih besar.
Samsung juga memperlihatkan memori yang mampu melakukan sebagian perhitungan secara internal. Pendekatan ini bertujuan mengurangi frekuensi data harus dikirim ke prosesor terpisah. Setiap usulan menyasar masalah yang berkaitan: pemindahan informasi membutuhkan waktu dan daya, sekalipun chip komputasinya sangat cepat.
zHBM dan HBF masih berada pada tahap konsep dan pengembangan, sementara jadwal komersialisasi dan adopsi oleh pelanggan belum diputuskan. Untuk produksi Vera Rubin saat ini, produksi dan pengiriman HBM4 tetap menjadi prioritas langsung.
Tonggak produksi yang perlu dicermati
Nvidia memulai produksi penuh setelah berbulan-bulan proses kualifikasi memori, ekspansi pabrik, dan demonstrasi produk masa depan. Tonggak-tonggak utama menunjukkan makin eratnya keterkaitan jadwal produksi prosesor dan memori:
- Awal 2026: HBM4 Micron memasuki produksi massal.
- Mei dan Juni 2026: Samsung dan SK hynix mengirimkan sampel HBM4E kepada pelanggan.
- Juni 2026: Huang mengonfirmasi ketiga pemasok HBM utama telah lolos kualifikasi dan mulai berproduksi untuk Vera Rubin.
- 7 Oktober 2026: Serikat pekerja Micron di Taoyuan menyetujui aksi mogok.
- 14-16 Oktober 2026: Samsung dan SK hynix memamerkan teknologi memori di SEDEX, Seoul.
- Pertengahan Oktober 2026: Micron membuka fasilitas pengemasan dan pengujian AATT2 di Taichung.
- 22 Oktober 2026: Mediasi yang melibatkan serikat pekerja Micron di Taichung dijadwalkan.
- Pertengahan 2027: Micron menargetkan pengiriman produk secara penuh dari lokasi Tongluo yang diperluas.
Samsung dan SK hynix berpeluang meraih manfaat dari meningkatnya kebutuhan memori Vera Rubin, sementara kapasitas Micron yang sudah dikontrak menunjukkan ketatnya persaingan untuk mendapatkan pasokan yang tersedia. Pelanggan membutuhkan sistem lengkap, sehingga perakitan node yang cepat harus diimbangi dengan pasokan memori yang cukup, pengemasan yang andal, dan operasional pabrik yang lancar.
Poin Penting
- Nvidia mengatakan Vera Rubin telah memasuki produksi penuh, dengan waktu perakitan node kurang dari lima menit, dibandingkan dua jam sebelumnya.
- Platform ini menggunakan pendinginan cair menyeluruh dan HBM4 dari Samsung, SK hynix, serta Micron yang telah lolos kualifikasi.
- Tumpukan HBM4 Samsung dengan 12 lapisan memiliki kapasitas 36 gigabita; tumpukan 16 lapis SK hynix yang dipamerkan memiliki kapasitas 48 gigabita.
- Micron mengatakan seluruh kapasitas yang direncanakan untuk 2027 di fasilitas HBM barunya di Taichung sudah dikontrak.
- Pengemasan canggih, ketersediaan peralatan, dan perundingan tenaga kerja tetap menjadi faktor praktis dalam jadwal pengiriman.
- Samsung dan SK hynix menguji HBM4E sembari mengembangkan cara baru untuk menempatkan dan mengatur memori AI.