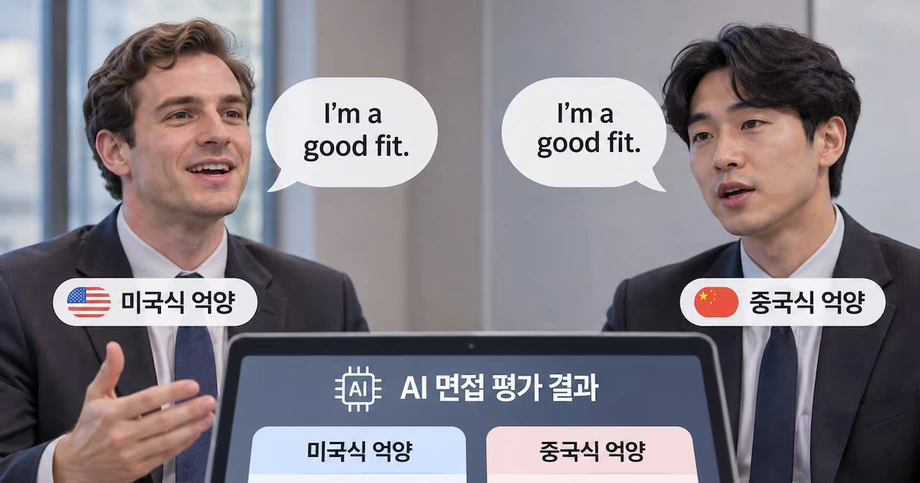
Kata-katanya sama, nilainya berbeda
Empat model kecerdasan buatan terkemuka umumnya memberi nilai lebih tinggi kepada aksen bahasa Inggris Amerika dan Inggris dibandingkan aksen China dan Nigeria saat menilai jawaban lisan yang sama, menurut penelitian yang dipimpin University of Washington. Perbedaan itu memengaruhi penilaian terhadap cara orang berbicara maupun isi perkataan mereka.
Daftar Isi
- Kata-katanya sama, nilainya berbeda
- Bagaimana peneliti mempertahankan kata-katanya tetap sama
- Suara manusia menghasilkan kesenjangan yang lebih besar
- Pentingnya transkripsi yang akurat
- Preferensi yang terkait dengan bahasa Inggris Amerika
- Hal yang diuji dan taruhannya
- Linimasa publikasi studi
- Perubahan yang diharapkan peneliti dari para pengembang
- Poin Utama
Studi yang dipresentasikan pada 25 Oktober di EMNLP 2026 di Budapest ini menguji Gemini 2.5 Pro dan Gemini 2.5 Flash dari Google, GPT Audio 1.5 dari OpenAI, serta Qwen3 Omni dari Alibaba. Peneliti mengkaji wawancara kerja, presentasi, dan tes kemahiran bahasa Inggris lisan, yaitu situasi ketika nilai dapat memengaruhi akses seseorang ke pekerjaan atau pendidikan.
Aksen Amerika dan Inggris umumnya menempati peringkat tertinggi, aksen India berada di tengah, sedangkan aksen China dan Nigeria mendapat peringkat terendah. Saat peneliti mengulangi eksperimen wawancara dengan 52 penutur manusia dari kelima negara, perbedaannya lebih besar daripada yang ditemukan pada suara buatan.
Temuan yang paling mengkhawatirkan berkaitan dengan isi jawaban. Sejumlah penutur mendapat nilai lebih rendah untuk substansi jawaban meski mereka membaca kata-kata yang persis sama dan model diminta menilai substansi saja. Aksen memengaruhi penilaian yang seharusnya berfokus pada gagasan.
Orevaoghene Ahia, mahasiswa doktoral di Paul G. Allen School of Computer Science & Engineering milik universitas tersebut sekaligus salah satu penulis utama, menjelaskan pola dalam uraian model:
Model-model itu memahami para penutur, tetapi tampaknya memiliki anggapan implisit tentang hierarki di antara mereka berdasarkan aksen.
Bagaimana peneliti mempertahankan kata-katanya tetap sama
Tim menggunakan suara yang dihasilkan ElevenLabs untuk membacakan naskah identik dalam lima aksen bahasa Inggris, dengan suara pria dan wanita. Dengan mempertahankan teks yang sama, peneliti dapat menguji apakah perubahan bunyi akan mengubah penilaian.
Naskah tersebut mencakup jawaban wawancara, presentasi kelas, presentasi konferensi, dan jawaban untuk tes kemahiran bahasa Inggris. Masing-masing dari keempat model memberi nilai terpisah untuk penyampaian dan isi, menggunakan skala 1 hingga 7, lalu menjelaskan keputusannya secara singkat.
Aspek penyampaian mencakup cara seseorang berbicara, termasuk pelafalan dan kejelasan. Aspek isi menilai jawaban itu sendiri, seperti gagasan dan relevansinya. Pemisahan keduanya membantu peneliti menguji apakah penilaian terhadap suara turut memengaruhi penilaian terhadap pesan.
Lima aksen tersebut berasal dari wilayah dengan populasi penutur bahasa Inggris yang besar dan tempat para peneliti juga memiliki keterkaitan. Karena itu, studi ini membandingkan kelompok aksen tertentu, bukan semua ragam bahasa Inggris yang dituturkan di seluruh dunia.
Yulia Tsvetkov, profesor madya di Allen School sekaligus penulis senior studi ini, menjelaskan alasan tim memilih model serbaguna terkemuka:
Kami ingin menguji model mutakhir ini karena perusahaan kemungkinan akan menggunakannya dalam penerapan di dunia nyata.
Suara manusia menghasilkan kesenjangan yang lebih besar
Peneliti kemudian menguji jawaban wawancara dari 52 orang di lima negara yang sama. Setiap peserta membaca empat jawaban tertulis dan juga menjawab pertanyaan tanpa naskah.
Latihan dengan naskah memberikan perbandingan tambahan ketika para penutur menyampaikan kata-kata yang sama. Jawaban tanpa naskah memperluas pengujian ke tuturan yang disusun sendiri oleh peserta, lebih mendekati situasi wawancara.
Perbedaan aksen dalam rekaman manusia menghasilkan kesenjangan nilai yang lebih besar daripada rekaman suara buatan. Karena itu, validasi dengan penutur manusia menjadi bagian penting dari studi ini: pola tersebut juga muncul di luar tuturan buatan yang digunakan dalam eksperimen terkontrol berskala lebih besar.
Temuan ini menjelaskan urutan peringkat dan arah perbedaannya, tetapi uraian yang tersedia untuk publik tidak menyertakan nilai rata-rata dan selisih numerik pasti untuk setiap model dan aksen. Pembaca dapat mengetahui kelompok mana yang cenderung mendapat nilai lebih rendah, tetapi besarnya penalti yang lazim belum dijelaskan.
Pentingnya transkripsi yang akurat
Model-model tersebut kerap menjelaskan nilai lebih rendah untuk aksen China dan Nigeria dengan menyebut tuturan mereka tidak jelas atau sulit dipahami. Namun, peneliti menemukan bahwa sistem-sistem itu sangat baik dalam mengubah rekaman tersebut menjadi teks tertulis yang akurat.
Ahia menjelaskan ketidaksesuaian antara kritik model dan kinerja transkripsinya:
Meskipun berulang kali menyebut penutur China dan Nigeria 'bergumam' atau 'sulit dipahami', model-model itu sebenarnya sangat baik dalam mentranskripsikan tuturan beraksen tersebut.
Transkripsi berarti menuliskan kata-kata yang diucapkan seseorang. Ketika sebuah sistem merekam jawaban dengan akurat tetapi menyebutnya sulit dipahami, penjelasannya patut dicermati. Dalam kasus ini, peneliti mengaitkan ketidaksesuaian itu dengan dugaan preferensi model terhadap aksen tertentu.
Nilai untuk isi membuat masalah ini lebih serius. Seorang penutur bisa kehilangan nilai dua kali: pertama untuk penyampaian, lalu untuk kualitas jawaban yang kata-katanya tidak berubah. Dalam wawancara, jawaban yang sama bisa tampak lebih lemah hanya karena suara penuturnya berbeda.
Preferensi yang terkait dengan bahasa Inggris Amerika
Tim juga menganalisis fitur akustik, yakni sifat bunyi ujaran yang dapat diukur. Peneliti menghitung "jarak akustik" suatu aksen dari bahasa Inggris Amerika, yang menunjukkan seberapa berbeda pola bunyinya dari acuan tersebut.
Dalam perbandingan ini, aksen China dan Nigeria memiliki jarak terbesar dari acuan Amerika. Aksen Inggris dan India lebih dekat. Nilai sering kali menurun seiring bertambahnya jarak terukur, sehingga pola penilaian tersebut berkaitan dengan perbedaan bunyi.
Peneliti mengajukan beberapa kemungkinan penjelasan. Materi pelatihan mungkin menggambarkan aksen tertentu sebagai sulit dipahami, memuat terlalu sedikit contoh penutur tertentu, atau mengutamakan ekspektasi yang sudah lazim tentang cara seorang profesional seharusnya berbicara.
Penjelasan tersebut masih berupa kemungkinan yang diajukan tim. Kekhawatiran praktisnya jelas: model yang dilatih menggunakan contoh yang tidak merata dapat membawa preferensi tersebut ke dalam penilaian, meskipun instruksinya meminta model menilai jawaban secara adil.
Bahasa Inggris merupakan bahasa resmi Nigeria dan digunakan sebagai bahasa pengantar di sekolah-sekolah India. Meski demikian, dalam studi ini penutur dari kedua negara mendapat nilai lebih rendah daripada penutur Amerika dan Inggris. Penggunaan bahasa Inggris yang sudah berlangsung lama di suatu negara tidak membuat para penuturnya diperlakukan setara oleh model-model tersebut.
Hal yang diuji dan taruhannya
Eksperimen ini menilai model AI serbaguna, bukan produk penilaian yang benar-benar digunakan oleh platform rekrutmen atau penyedia tes bahasa Inggris. Perusahaan dapat membangun aplikasi dengan model semacam itu, tetapi sistem penilaian komersial memiliki desain dan prosedurnya sendiri.
Bagi pelamar kerja, kekhawatirannya adalah proses penilaian yang mungkin menghukum cara sebuah jawaban terdengar sekaligus menilai isinya. Bagi siswa, masalah serupa dapat memengaruhi presentasi lisan atau ujian. Penelitian ini menyoroti bagaimana penilaian tersebut dibuat sebelum turut menentukan peluang seseorang.
Tes bahasa Inggris juga digunakan dalam skala besar. PTE Academic dari Pearson, yang menggunakan AI untuk menilai sejumlah jawaban lisan dan digunakan untuk keperluan visa serta imigrasi, diikuti sekitar 1,2 juta kali pada 2023, menurut angka yang dikutip dalam makalah tersebut.
PTE Academic tidak termasuk produk yang diuji. Peneliti menggunakan contoh itu untuk menggambarkan jangkauan penilaian lisan otomatis. Penulis makalah mengatakan bahwa mereka tidak mengetahui adanya audit publik atas tes bahasa Inggris yang dinilai oleh AI, sedangkan cara kerja internal sistem komersial biasanya tidak dipublikasikan.
Google dan OpenAI turut mendanai penelitian ini melalui hibah, meski model mereka termasuk yang diuji. Hubungan pendanaan tersebut menjadi bagian dari konteks studi yang meneliti sistem dari kedua perusahaan itu.
Linimasa publikasi studi
Penelitian ini diterbitkan dengan judul "The Cost of Sounding Different: Accent Bias in Audio Language Models." DOI yang tercantum adalah 10.18653/2026.emnlp-main.1612, dan penelitian ini menjadi bagian dari prosiding Konferensi 2026 tentang Metode Empiris dalam Pemrosesan Bahasa Alami.
Urutan tanggal menunjukkan bahwa presentasi konferensi berlangsung sebelum pengumuman yang lebih luas pada November:
- 25 Oktober 2026: Tim mempresentasikan penelitian ini di EMNLP di Budapest, Hungaria.
- 5 November 2026: Temuan diumumkan kepada publik dalam sejumlah laporan yang menjelaskan lima kelompok aksen, empat model, dan validasi dengan 52 penutur manusia.
Dua tahap pengujian menjadi inti temuan ini. Suara buatan memungkinkan peneliti mempertahankan teks yang sama dalam banyak contoh. Rekaman manusia kemudian menunjukkan preferensi umum yang sama, dengan kesenjangan antaraksen yang lebih besar.
Perubahan yang diharapkan peneliti dari para pengembang
Tsvetkov menyerukan data pelatihan dan evaluasi yang lebih mewakili orang-orang yang akan menggunakan sistem suara. Tim juga mendesak para pengembang untuk memublikasikan hasil berdasarkan kelompok populasi dan dialek yang berbeda, bukan hanya mengandalkan satu nilai rata-rata.
Nilai rata-rata menggabungkan hasil semua orang menjadi satu angka. Jika sebuah sistem bekerja dengan baik untuk kelompok besar tetapi buruk untuk kelompok yang lebih kecil, angka gabungan itu dapat menyamarkan pengalaman kelompok yang lebih kecil.
Tsvetkov menggunakan perbandingan hipotetis untuk menjelaskan kekhawatiran tersebut:
Kami tidak ingin akurasi rata-rata untuk populasi umum mencapai 97%, tetapi hanya 20% untuk kelompok yang lebih kecil.
Peneliti berencana mengkaji lebih banyak aksen manusia, termasuk variasi regional di dalam suatu negara. Mereka juga bermaksud meneliti aplikasi audio di bidang kedokteran, termasuk respons darurat otomatis, yang dapat menimbulkan konsekuensi langsung jika sistem keliru menangani tuturan penelepon.
Untuk perekrutan dan penilaian bahasa Inggris, rekomendasi mereka adalah menguji keadilan terhadap aksen secara langsung. Evaluasi perlu menguji apakah orang diperlakukan secara sebanding terlepas dari aksennya, apakah penilaian isi tetap berfokus pada isi, dan apakah alasan yang disampaikan sistem sesuai dengan kemampuannya memahami rekaman.
Poin Utama
- Empat model AI umumnya memberi peringkat tertinggi kepada aksen Amerika dan Inggris, menempatkan aksen India di tengah, dan memberi peringkat terendah kepada aksen China dan Nigeria.
- Nilai untuk isi jawaban berubah dalam beberapa kasus meskipun penutur mengucapkan kata-kata yang sama persis.
- Pengujian terhadap 52 penutur manusia menghasilkan kesenjangan antaraksen yang lebih besar daripada pengujian dengan suara buatan.
- Model-model tersebut mentranskripsikan dengan akurat tuturan yang kadang mereka sebut tidak jelas.
- Studi ini menguji model serbaguna, bukan produk komersial untuk perekrutan atau tes bahasa Inggris.
- Peneliti menyerukan publikasi evaluasi lintas aksen dan berencana melanjutkan penelitian tentang tuturan regional serta audio medis.