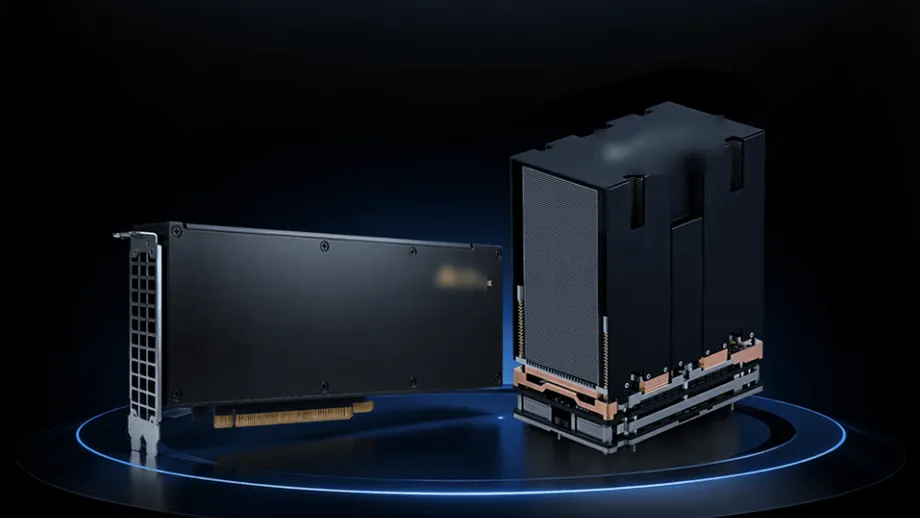
GPU yang berfungsi dan klaim throughput 5%
Iluvatar CoreX telah mendemonstrasikan prosesor grafis Tiangai 300 secara terbuka di Shanghai, dengan menyajikannya sebagai alternatif buatan China untuk H200 Nvidia dan mengklaim keunggulan 5% dalam uji inferensi pihak ketiga. Pada hari terbuka media tanggal 28 Oktober 2026, perusahaan itu juga memperlihatkan sistem pelatihan delapan GPU serta menjelaskan rak yang memuat 144 GPU dan 18 CPU.
Daftar Isi
- GPU yang berfungsi dan klaim throughput 5%
- Hal yang diukur dalam perbandingan dengan H200
- Dokumen panjang dan respons awal lebih cepat
- Hasil pelatihan menggunakan acuan Nvidia yang berbeda
- Dari peluncuran Juli hingga demonstrasi Oktober
- Rak yang dirancang untuk 144 GPU
- Membagi pekerjaan AI di antara berbagai chip
- Klaim perangkat lunak menargetkan waktu penerapan
- TY1200 memperluas tawaran ke robot
- Poin Penting
Perbandingan utama tersebut berasal dari pengujian yang diselesaikan Shanghai Electric Group pada Juli, menurut Iluvatar CoreX. Dalam penerapan yang memisahkan dua tahap pemrosesan model bahasa besar, Tiangai 300 mencapai throughput ujung ke ujung setara 1,05 kali H200 setelah hasilnya dikonversi menjadi angka per kartu.
Throughput berarti seberapa banyak pekerjaan berguna yang diselesaikan suatu sistem dalam jangka waktu tertentu. Untuk chatbot, ini dapat berarti berapa banyak teks yang dihasilkan setiap detik. Hasil sebesar 1,05 kali kinerja acuan berarti keluaran 5% lebih banyak dalam kondisi pengujian tersebut.
Perusahaan menyebut Tiangai 300 sebagai GPU serbaguna pertama buatan China yang mencapai kinerja H200 dalam pengujian terukur. Demonstrasi pada Oktober memperluas perbandingan ke model bahasa, pembuatan gambar dan video, sementara demonstrasi pelatihan terpisah menggunakan H100 Nvidia sebagai acuan.
Acara itu menampilkan lebih dari sekadar spesifikasi chip. Iluvatar CoreX memperkenalkan kartu, server, desain rak berkerapatan tinggi, perangkat lunak, serta metode untuk membagi pekerjaan AI di antara berbagai jenis prosesor. Tawaran komersialnya adalah bahwa komponen-komponen ini dapat menghasilkan keluaran AI yang berguna dengan biaya lebih rendah dan waktu tunggu lebih singkat.
Hal yang diukur dalam perbandingan dengan H200
Pengujian Shanghai Electric Group pada Juli menggunakan pemisahan prefill dan decode, yang sering disingkat menjadi pemisahan PD. Prefill adalah tahap ketika model bahasa membaca permintaan pengguna dan materi pendukungnya. Decode adalah tahap ketika model menghasilkan jawaban, satu token setiap kali. Token adalah potongan kecil yang digunakan sistem AI untuk membagi teks.
Pemisahan kedua tahap tersebut memungkinkan sistem mengalokasikan sumber daya secara berbeda untuk membaca dan menulis. Karena itu, hasil Tiangai 300 berkaitan dengan konfigurasi penerapan tertentu, dengan kinerja total dinyatakan sebagai angka ekuivalen untuk satu kartu.
Iluvatar CoreX belum menerbitkan metode pengujian terperinci, daftar model, atau kondisi beban kerja di balik hasil utama pihak ketiga tersebut. Perincian itu, bersama perhitungan konversi dan pengaturan perangkat lunak, diperlukan agar hasilnya dapat direproduksi secara independen. Perbandingan biaya juga belum dilengkapi rincian yang dipublikasikan, sementara angka memori untuk kartu individual dan keseluruhan rak perlu diperjelas.
Demonstrasi yang disebutkan oleh laboratorium kinerja memberikan gambaran lebih terperinci mengenai klaim perusahaan. Hasilnya menunjukkan peningkatan yang berbeda-beda untuk tiap tugas, dari kenaikan kecil dalam pembuatan konten multimodal hingga peningkatan throughput rekomendasi yang lebih besar. Bagi calon pembeli, perbandingan yang relevan adalah dengan tugas yang benar-benar dijalankan layanan mereka.
Dokumen panjang dan respons awal lebih cepat
Kinerja attention Tiangai 300 mencapai 1,05 kali kinerja H200 pada panjang konteks 64K, menurut laboratorium perusahaan. Attention adalah proses yang membantu model menentukan bagian mana dari masukan yang saling berkaitan. Panjang konteks 64K berarti model menangani sekitar 64.000 token.
Untuk GLM-5.3 pada skala konteks yang sama, Iluvatar CoreX mengklaim throughput 1,15 kali kinerja H200 dengan pengalaman pengguna yang setara. Itu berarti peningkatan 15% untuk beban kerja model mixture of experts yang diuji. Model mixture of experts mengarahkan pekerjaan ke jaringan spesialis tertentu, alih-alih menggunakan semua jaringan untuk setiap token.
Untuk beban kerja agen AI dengan konteks mulai dari 8K hingga 128K, perusahaan melaporkan pengurangan waktu tunggu sekitar 10% hingga 30% sebelum token keluaran pertama muncul. Ukuran ini penting bagi orang yang menunggu asisten mulai menjawab setelah membaca dokumen panjang atau memproses permintaan rumit.
Pembuatan gambar dan video menjadi bagian lain dari demonstrasi. Perusahaan melaporkan peningkatan throughput pembuatan multimodal sekitar 2% hingga 5% dibandingkan H200. Untuk beban kerja pencarian daring, periklanan, dan rekomendasi, perusahaan mengklaim throughput inferensi rekomendasi 21% lebih tinggi dan latensi komputasi ringan 26% lebih rendah.
Hasil pelatihan menggunakan acuan Nvidia yang berbeda
Demonstrasi pelatihan menggunakan Qwen3-32B, model dengan sekitar 32 miliar parameter, pada server delapan GPU. Parameter adalah nilai numerik yang disesuaikan model selama pelatihan untuk mempelajari pola. Iluvatar CoreX mengatakan throughput efektif per kartu mencapai 1,33 kali throughput H100 Nvidia.
Dengan demikian, keunggulan yang dilaporkan dalam demonstrasi pelatihan tersebut adalah 33%, dengan H100 sebagai chip pembanding. Hasil inferensi lain yang ditampilkan dalam acara itu menggunakan H200. Memisahkan kedua produk acuan ini penting untuk memahami angka-angkanya.
Sistem pelatihan beroperasi pada presisi FP8. FP8 menyimpan angka menggunakan delapan bit, sehingga mengurangi jumlah data yang harus dipindahkan dan diproses dibandingkan format yang menggunakan lebih banyak bit. Perangkat lunak pelatihan AI harus mengelola presisi yang lebih rendah ini dengan cermat agar kualitas pembelajaran tetap terjaga.
Iluvatar CoreX juga melaporkan variasi waktu langkah sebesar 0,43% selama operasi berkepanjangan pada beban penuh, dibandingkan 0,76% pada sistem acuan berbasis Hopper. Waktu langkah adalah waktu yang dibutuhkan untuk menyelesaikan satu unit pekerjaan yang berulang. Waktu yang lebih konsisten dapat membantu operator memperkirakan jumlah pekerjaan yang mampu diselesaikan sistem yang sibuk.
Dari peluncuran Juli hingga demonstrasi Oktober
Tiangai 300 diperkenalkan secara resmi di World Artificial Intelligence Conference pada Juli 2026. GPU ini menggunakan arsitektur Tianshu milik perusahaan, mengintegrasikan Tensor Core generasi baru, dan memiliki spesifikasi memori grafis 144GB.
Prosesor ini mendukung operasi skalar, vektor, dan tensor. Secara sederhana, ketiganya menangani angka tunggal, kelompok angka, dan larik matematika yang lebih besar. Format numerik yang didukung mencakup FP4, FP8, FP16, dan BF16, sehingga pengembang perangkat lunak memiliki sejumlah pilihan untuk kecepatan, penggunaan memori, dan presisi numerik.
Tahapan penting yang disampaikan perusahaan berlangsung selama beberapa bulan:
- Juli 2026: Tiangai 300 diluncurkan di World Artificial Intelligence Conference.
- Juli 2026: Shanghai Electric Group menyelesaikan pengujian pihak ketiga yang dikutip untuk perbandingan throughput dengan H200.
- Sebelum acara media Oktober: desain rak IXL144 diperlihatkan di China International Industry Fair.
- 28 Oktober 2026: Iluvatar CoreX membuka demonstrasi langsung perangkat keras Tiangai 300 bagi media di Shanghai.
Acara Oktober mengalihkan fokus produk dari presentasi arsitektur ke sistem yang menjalankan beban kerja yang disebutkan secara spesifik. Rentang penerapan yang dijelaskan perusahaan kini mencakup kartu akselerator individual, server dengan delapan kartu, hingga sistem IXL144 yang lebih besar.
Rak yang dirancang untuk 144 GPU
IXL144 menggabungkan 144 GPU dan 18 CPU dalam satu rak standar, dengan total memori GPU sekitar 10,1TB, menurut Iluvatar CoreX. Perusahaan menyebutnya sebagai supernode GPU terpadat di industri yang ditempatkan dalam satu rak. Supernode menghubungkan banyak prosesor secara erat agar dapat bekerja sama menangani tugas besar.
Spesifikasi 144GB per Tiangai 300 dan angka total 10,1TB untuk rak membutuhkan perincian konfigurasi yang lebih jelas. Perkalian 144 kartu dengan 144GB menghasilkan 20.736GB, sebelum memperhitungkan perbedaan cara kapasitas dihitung. Penjelasan tentang rak perlu menyebutkan konfigurasi kartu dan kapasitas memori yang tersedia untuk beban kerja.
Iluvatar CoreX memperkirakan sistem tersebut dapat mengurangi biaya per satu juta token efektif sekitar 40% dibandingkan sistem internasional arus utama. Token efektif merujuk pada keluaran yang dihitung sebagai pekerjaan berguna. Bagi operator yang menjual layanan AI, ukuran ini menghubungkan belanja perangkat keras dengan jumlah keluaran berguna yang dihasilkan.
Penurunan 40% berarti biaya 60 unit untuk pekerjaan yang berbiaya 100 unit pada sistem acuan. Penghematan nyata akan bergantung pada harga peralatan, penggunaan daya, perangkat lunak, beban kerja, dan seberapa konsisten GPU digunakan secara optimal.
Perusahaan itu juga menyampaikan sasaran untuk mesin interkoneksi peer-to-peer generasi berikutnya: mengurangi satu kali transfer dalam domain yang terhubung dari 3 hingga 5 mikrodetik menjadi 1 mikrodetik. Komunikasi yang lebih cepat membantu ketika GPU yang berbeda menyimpan bagian-bagian model yang berbeda dan harus berulang kali bertukar data.
Membagi pekerjaan AI di antara berbagai chip
Pendekatan penerapan heterogen Iluvatar CoreX membagi bagian-bagian inferensi ke berbagai jenis prosesor. Dalam skema pemisahan AFD, Tiangai 300 menangani seluruh tahap prefill dan perhitungan attention selama decode. XPU mitra menangani jaringan pakar feed forward.
XPU adalah istilah umum untuk jenis akselerator komputasi lain. Gagasan dasarnya adalah memberikan setiap prosesor pekerjaan yang paling dikuasainya, sementara penjadwal bersama mengoordinasikan keseluruhan tugas. Jaringan feed forward menjalankan bagian penting lain dari pemrosesan matematis di dalam model bahasa.
Perusahaan melaporkan pengurangan latensi inferensi decode sebesar 60% dengan penjadwalan terpadu. Konfigurasi sistem ini berbeda dari klaim utama keunggulan throughput 5% atas H200, dan menggunakan ukuran kinerja yang berbeda.
Shan Tianyi, kepala AI dan komputasi akselerasi perusahaan, mengatakan sistem komputasi AI masa depan akan bergantung pada pengaturan berbagai chip secara efisien, alih-alih mengandalkan satu jenis prosesor untuk setiap tugas. Demonstrasi AFD menerapkan strategi tersebut dalam konfigurasi konkret yang terdiri atas GPU dan akselerator mitra.
Klaim perangkat lunak menargetkan waktu penerapan
Iluvatar CoreX juga memperkenalkan tumpukan perangkat lunak AI untuk AI yang ditujukan untuk mengotomatiskan sebagian proses penerapan dan optimasi. Perusahaan mengatakan waktu penyiapan lingkungan turun dari satu jam menjadi 10 menit, sementara jumlah operasi manual berkurang dari puluhan menjadi satu.
Untuk satu tugas optimasi model besar, perusahaan melaporkan pemangkasan siklus kerja dari tujuh hari menjadi kurang dari dua jam, dengan kinerja mendekati dua kali tingkat sebelumnya. Contoh-contoh ini berkaitan dengan pekerjaan rekayasa yang diperlukan agar model berjalan efisien pada perangkat keras tersebut.
Perusahaan juga mengklaim integrasi mendalam dengan FlyDSL, bahasa yang digunakan untuk mengembangkan rutinitas komputasi GPU. Perusahaan menyebut kecepatan kompilasi meningkat lebih dari 90% dan menjelaskan bahwa alur kerja yang sebelumnya membutuhkan 10 orang bekerja selama satu hari kini dapat diselesaikan satu orang dalam hitungan jam.
Dukungan perangkat lunak penting karena prosesor membutuhkan lebih dari sekadar perangkat keras yang mampu melakukan perhitungan. Model, pustaka matematika, dan perangkat penerapan harus bekerja bersama. Demonstrasi perangkat lunak tersebut menunjukkan besarnya upaya rekayasa yang mungkin dibutuhkan pelanggan sebelum dapat mengubah GPU baru menjadi layanan yang berfungsi.
TY1200 memperluas tawaran ke robot
Acara di Shanghai itu juga menampilkan Tongyang TY1200, prosesor terpisah yang ditujukan untuk PC AI dan kecerdasan berwujud, termasuk robot yang merasakan lingkungan dan bertindak di dunia fisik. Kemampuan komputasi padatnya disebut mencapai 300 TOPS, atau 300 triliun operasi per detik. Komputasi padat menghitung pekerjaan tanpa mengandalkan penghilangan perhitungan yang melibatkan nilai nol.
Iluvatar CoreX mengklaim TY1200 mencapai 1,2 kali kinerja Nvidia Thor T5000 dalam pengujian yang melibatkan Qwen3.8-27B dan Qwen3.6-35B-A3B. Untuk model Cosmos-R2-2B dan Cosmos-R2-8B dalam skenario AI fisik, perusahaan melaporkan kinerja masing-masing setara dengan 158% dan 180% dari acuan Thor T5000.
Perusahaan juga mengatakan TY1200 dapat menjalankan simulasi fisika yang dipercepat GPU menggunakan MuJoCo-Warp. Sistem pengembangan robot dapat menggunakannya untuk menyimulasikan gerakan, melatih kebijakan kontrol, dan memeriksa tindakan secara lokal. Kebijakan kontrol adalah serangkaian instruksi hasil pembelajaran yang digunakan robot untuk menentukan cara bergerak.
Aplikasi yang dilaporkan mencakup robot yang membantu orang saat kunjungan medis, visi industri, dan panduan pengunjung. Produk penerus yang direncanakan, TY2000, memiliki sasaran komputasi sebesar 600T. Bersama-sama, produk-produk ini memperluas strategi perusahaan dari server AI besar ke perangkat yang beroperasi di dekat pengguna dan mesin.
Poin Penting
- Iluvatar CoreX mendemonstrasikan perangkat keras Tiangai 300 di Shanghai pada 28 Oktober 2026.
- Perusahaan mengutip pengujian Shanghai Electric Group yang menunjukkan throughput per kartu setara 1,05 kali kinerja Nvidia H200.
- Demonstrasi pelatihan Qwen3-32B dengan delapan GPU dilaporkan menghasilkan throughput per kartu 1,33 kali H100 pada presisi FP8.
- Metode terperinci di balik tolok ukur utama pihak ketiga belum dipublikasikan.
- Rak IXL144 berisi 144 GPU dan 18 CPU, dengan klaim pengurangan biaya per satu juta token efektif sebesar 40%.
- Penerapan terpisah yang membagi pekerjaan antara GPU dan XPU dilaporkan mengurangi latensi decode sebesar 60%.
- Acara itu juga membahas otomatisasi perangkat lunak dan aplikasi TY1200 dalam AI lokal serta simulasi robotika.