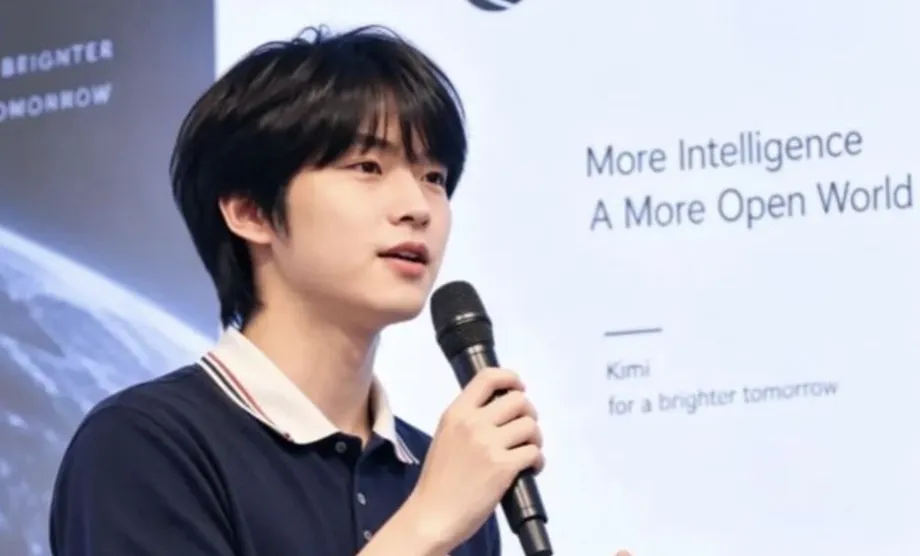
Peneliti remaja hengkang setelah membantu merancang ulang Kimi
Chen Guangyu, peneliti berusia 17 tahun yang membantu mengembangkan cara baru bagi model kecerdasan buatan untuk meneruskan informasi antarlapisan, mengumumkan pada 15 Oktober 2026 bahwa ia telah meninggalkan Moonshot AI, perusahaan China di balik Kimi. Ia bergabung dengan tim risetnya pada November 2025, saat berusia 16 tahun.
Daftar Isi
- Peneliti remaja hengkang setelah membantu merancang ulang Kimi
- Kontribusi Chen dalam riset
- Bagaimana Attention Residuals mengubah model
- Hasil yang ditunjukkan publikasi
- Dari hackathon sekolah ke tim riset
- Kronologi karier yang melesat
- Undangan Anthropic dan kabar tawaran jutaan dolar
- Alasan Discovery Loop ikut diperbincangkan
- Dampak kepergiannya bagi Moonshot
- Poin Utama
Dikenal secara internasional sebagai Nathan Chen, remaja asal Shenzhen ini pergi dengan kontribusi riset yang nyata: menjadi salah satu penulis pertama dengan kontribusi setara untuk Attention Residuals, makalah yang diterbitkan pada 16 Maret 2026 bersama peneliti Moonshot, Yu Zhang dan Jianlin Su. Menurut sejumlah laporan tentang peluncuran model tersebut pada Juli, teknik ini kemudian menjadi bagian dari Kimi K3.
Eksperimen yang dipublikasikan Moonshot memberikan gambaran yang lebih tepat tentang hasil kerjanya dibandingkan perhatian yang tertuju pada usianya. Dalam pengujian model Kimi Linear dengan 48 miliar parameter, para peneliti mencatat peningkatan pada setiap tugas yang dievaluasi. Metode Block Attention Residuals mereka juga menyamai loss pelatihan model konvensional yang menggunakan daya komputasi 1,25 kali lebih besar.
Kepergian Chen memicu undangan terbuka dari Anthropic, spekulasi mengenai perusahaan rintisan yang didirikan mantan peneliti Google, serta upaya mengaitkannya dengan seorang remaja yang tak disebutkan namanya dan dilaporkan menerima lima tawaran kerja senilai sekitar $1 juta atau lebih per tawaran.
Namun, Chen secara terbuka membantah kabar bahwa ia akan bergabung dengan Anthropic. Perusahaan tempatnya bekerja berikutnya, paket kompensasi apa pun, dan apakah ia akan kembali ke universitas masih belum dikonfirmasi.
Dalam pesan perpisahannya, Chen menceritakan waktunya di Moonshot dan berterima kasih kepada orang-orang yang merekrutnya. Asisten peneliti pembelajaran mesin yang akan hengkang itu mengatakan:
Tahun lalu adalah tahun terbaik dalam hidup saya.
Pesannya diakhiri dengan keinginan untuk terus menjelajah, tanpa menyebutkan tujuan tertentu.
Kontribusi Chen dalam riset
Nama Chen tercantum bersama Zhang dan Su dengan keterangan kontribusi setara dalam laporan Attention Residuals tim Kimi. Keterangan itu mengakui bahwa ketiganya memimpin kontribusi dalam upaya tim yang jauh lebih besar.
Su, yang dikenal atas karyanya tentang rotary position embeddings atau RoPE, melakukan eksperimen awal. RoPE membantu model bahasa melacak posisi kata atau bagian informasi lain dalam suatu urutan. Zhang adalah penulis pertama riset arsitektur Kimi Linear.
Su mengakui bahwa Zhang dan Chen membantu mengembangkan gagasan awal Attention Residuals menjadi sesuatu yang praktis untuk model besar. Keduanya bersama-sama mengusulkan Block AttnRes, versi yang dirancang untuk mempertahankan manfaat metode itu sekaligus mengurangi kebutuhan memori dan komunikasi saat diterapkan dalam skala besar.
Chen juga mengerjakan percepatan kernel komputasi untuk Kimi Delta Attention atau KDA. Kernel adalah program kecil yang menjalankan perhitungan tertentu pada unit pemrosesan grafis. Penyempurnaannya dapat membuat perangkat keras yang sama menyelesaikan tugas lebih cepat.
Karena itu, pekerjaannya mencakup dua bidang yang saling terkait: menentukan rancangan model dan memastikan perhitungan di balik rancangan tersebut berjalan secara efisien. Bagi laboratorium yang melatih model besar, keduanya memengaruhi banyaknya riset yang dapat diselesaikan dengan anggaran komputasi yang tersedia.
Bagaimana Attention Residuals mengubah model
Model bahasa memproses informasi melalui banyak lapisan yang berurutan. Setiap lapisan mengubah informasi yang diterimanya, membentuk representasi yang digunakan lapisan berikutnya untuk memprediksi jawaban.
Koneksi residual standar menjaga informasi sebelumnya tetap mengalir dalam proses tersebut dengan menjumlahkan keluaran lapisan. Repositori riset resmi Moonshot menjelaskan masalah pendekatan ini: semakin dalam model, akumulasi berulang dapat mengencerkan kontribusi tiap bagian dan memperbesar sinyal internal.
Attention Residuals mengganti akumulasi tetap itu dengan proses seleksi yang dipelajari. Lapisan berikutnya dapat memberikan bobot berbeda pada informasi yang dihasilkan sebelumnya, bergantung pada masukan saat ini. Bayangkan seorang pembaca merujuk pada catatan paling berguna dari bab-bab sebelumnya, alih-alih membawa setiap catatan ke depan dengan tingkat kepentingan yang sama.
Menerapkan seleksi itu secara terpisah pada setiap lapisan sebelumnya menimbulkan biaya tersendiri. Block AttnRes mengelompokkan lapisan, mempertahankan penjumlahan biasa di dalam tiap kelompok, lalu menyeleksi representasi kelompok yang dihasilkan. Menurut repositori tersebut, sekitar delapan kelompok sudah menghasilkan sebagian besar peningkatan dari metode lengkap.
Konfigurasi Kimi Linear terbesar yang dijelaskan dalam makalah itu menggunakan 54 lapisan, yang dikelompokkan enam per kelompok. Sembilan kelompoknya, bersama representasi token awal, menyediakan 10 sumber informasi untuk diseleksi. Inilah langkah rekayasa praktis yang membantu membawa gagasan tersebut dari eksperimen menuju pelatihan model besar.
Hasil yang ditunjukkan publikasi
Makalah bulan Maret menguji Attention Residuals pada model Kimi Linear dengan total 48 miliar parameter, dengan 3 miliar di antaranya diaktifkan selama pemrosesan. Parameter adalah pengaturan numerik yang dipelajari di dalam model. Dengan mengaktifkan hanya sebagian parameter, model dapat memanfaatkan kumpulan besar pengetahuan yang dipelajari sekaligus membatasi perhitungan yang diperlukan pada setiap langkah.
Pelatihan menggunakan 1,4 triliun token, yaitu potongan teks atau data lain yang diproses model. Para peneliti mempertahankan komponen arsitektur utama model lainnya agar dapat membandingkan penambahan Attention Residuals dengan rancangan dasar.
Pada GPQA-Diamond, tes soal sains sulit, skor meningkat dari 36,9 menjadi 44,4, atau naik 7,5 poin. HumanEval, yang menguji kemampuan menghasilkan kode, naik dari 59,1 menjadi 62,2. MMLU, tolok ukur pengetahuan umum yang luas, naik dari 73,5 menjadi 74,6.
Perbandingan komputasi juga penting. Menyamai model dasar yang menggunakan komputasi 1,25 kali lebih besar berarti mencapai loss pelatihan yang sama dengan empat perlima anggaran model dasar tersebut, atau menggunakan komputasi 20% lebih sedikit. Loss pelatihan mengukur seberapa jauh prediksi model dari jawaban sasaran selama pelatihan.
Secara terpisah, Moonshot menyebut teknologi ini berkontribusi sekitar 25% pada peningkatan efisiensi pelatihan K3 dengan tambahan overhead kurang dari 2%. Eksperimen bulan Maret dan klaim K3 berikutnya merujuk pada konfigurasi model yang berbeda; angka tolok ukur terperinci yang dipublikasikan di atas berasal dari Kimi Linear.
Dari hackathon sekolah ke tim riset
Chen lahir di Shenzhen pada 2009. Sebelum bergabung dengan Moonshot, ia mengorganisasi komunitas sumber terbuka untuk remaja, mengembangkan bot perangkat lunak, dan mendalami berbagai minat mulai dari keamanan AI hingga fisika.
Saat mempersiapkan pendaftaran universitas, ia menghentikan sementara sejumlah kegiatan yang tidak ia sukai dan mulai membaca topik-topik yang menarik minatnya. Perjalanannya memasuki dunia riset kemudian menggabungkan belajar mandiri, tulisan teknis yang dipublikasikan secara terbuka, dan komunikasi dengan para peneliti.
Pada Februari 2025, ia mengikuti hackathon AI Moonshot untuk siswa sekolah menengah dengan ThirdArm, proyek yang membayangkan lengan robot tambahan untuk membantu pekerjaan. Di sana ia bertemu Dong Kehan, anggota tim pendiri MiraclePlus, yang mendorongnya berfokus pada teknologi mutakhir.
Sebuah tulisan teknis tentang DeltaNet kemudian mendapat tanggapan dari peneliti Songlin Yang. Diskusi itu sampai kepada Ben Keigwin dari Tilde Research, perusahaan rintisan di Palo Alto, California, dan berujung pada percakapan tentang pekerjaan mereka. Pada Juli 2025, Chen pergi sendirian ke sana saat berusia 16 tahun untuk menjalani magang selama tujuh minggu.
Metode belajar Chen mencakup berjam-jam membahas makalah dengan Gemini, mengirim tangkapan layar bagian yang sulit, dan mengajukan pertanyaan lanjutan. Ia juga membaca kode, blog, dan situs web peneliti, serta meminta saran dari peneliti DeepSeek Yuan Jingyang untuk mengambil keputusan penting.
Pengalamannya menunjukkan lebih dari sekadar penggunaan chatbot sebagai tutor. Tulisan yang dipublikasikan membuat pemikiran teknisnya terlihat, para peneliti menanggapinya, dan kesempatan magang memberinya peluang mengubah pemikiran tersebut menjadi kerja kolaboratif.
Kronologi karier yang melesat
Dalam waktu kurang dari dua tahun, Chen beralih dari proyek sekolah ke magang internasional, lalu ke riset model yang dipublikasikan. Ia hengkang setelah Attention Residuals digunakan dalam salah satu peluncuran besar Kimi.
- Februari 2025: Chen mengikuti hackathon AI Moonshot untuk siswa sekolah menengah.
- Juli 2025: Ia memulai magang selama tujuh minggu di Tilde Research, Palo Alto.
- November 2025: Ia bergabung dengan tim Kimi di Moonshot sebagai asisten peneliti pembelajaran mesin pada usia 16 tahun.
- 16 Maret 2026: Laporan teknis Attention Residuals diterbitkan dengan mencantumkan Chen, Zhang, dan Su sebagai kontributor setara.
- Juni 2026: Chen lulus dari sekolah menengah.
- Juli 2026: Kimi K3 diluncurkan dengan Attention Residuals sebagai salah satu teknologi arsitekturnya.
- 15 Oktober 2026: Chen mengumumkan bahwa ia telah meninggalkan Moonshot.
- 16 Oktober 2026: Ia membantah spekulasi bahwa dirinya akan bergabung dengan Anthropic.
- 20 Oktober 2026: Sebuah akun anonim mengklaim bahwa ia akan bergabung dengan Discovery Loop.
Riwayat pendidikan yang ia publikasikan juga mencantumkan kehadirannya di Carnegie Mellon University pada Agustus dan September 2026. Keterangan singkat itu menjadi bagian dari spekulasi tentang apakah langkah berikutnya adalah bekerja atau melanjutkan studi.
Undangan Anthropic dan kabar tawaran jutaan dolar
Sholto Douglas, yang memimpin scalable reinforcement learning di Anthropic, mengomentari unggahan perpisahan Chen. Ia bertanya apakah Chen masih berencana kuliah di Carnegie Mellon dan mengundangnya untuk bekerja bersama di San Francisco.
Chen menjawab bahwa ia sedang menuju Bay Area. Ketika percakapan itu memicu dugaan bahwa ia telah bergabung dengan Anthropic, ia membantahnya secara singkat:
tidak :)
Pembahasan gaji bermula secara terpisah. Investor Menlo Ventures, Deedy Das, menceritakan pertemuannya dengan seorang remaja berusia 17 tahun yang belajar AI secara autodidak dengan bantuan model bahasa, menjalani magang sekitar satu tahun di sebuah perusahaan AI terkemuka, lalu keluar dari program sarjana berperingkat tinggi di Amerika Serikat setelah dua minggu.
Menurut Das, remaja tersebut menerima lima tawaran dari laboratorium AI terkemuka di San Francisco, masing-masing senilai sekitar $1 juta atau lebih. Das juga menyampaikan bahwa remaja itu lebih mengutamakan belajar daripada uang.
Pengguna media sosial mengaitkan deskripsi tersebut dengan Chen karena usia dan riwayat risetnya. Das tidak menyebut nama remaja itu, dan Chen belum mengonfirmasi bahwa tawaran tersebut ditujukan kepadanya. Karena itu, pembahasan ini menyangkut tawaran yang dilaporkan untuk seseorang yang tidak disebutkan namanya, bukan perjanjian kerja Chen yang telah diumumkan.
Undangan terbuka dari Douglas merupakan tanda ketertarikan yang lebih konkret: seorang peneliti senior secara terbuka mendorong Chen untuk bergabung dengannya. Bantahan Chen setelahnya juga memberi jawaban langsung atas spekulasi mengenai Anthropic.
Alasan Discovery Loop ikut diperbincangkan
Discovery Loop menjadi sorotan berikutnya setelah Arfur Grok, akun anonim yang melacak perpindahan tenaga kerja di bidang AI, mengklaim pada 20 Oktober bahwa Chen telah bergabung dengan perusahaan itu. Chen belum mengonfirmasi penunjukan tersebut, dan perusahaan rintisan itu menolak berkomentar mengenai urusan kepegawaian.
Perusahaan itu didirikan pada Agustus 2026 oleh mantan peneliti Google, Jeff Dean, Sanjay Ghemawat, Quoc Le, dan Oriol Vinyals. Tujuan yang dinyatakannya adalah menggunakan AI untuk mengotomatiskan riset ilmiah dan pembelajaran mesin, termasuk mengusulkan gagasan, menjalankan eksperimen, dan menganalisis hasil.
Bagi peneliti yang tertarik pada desain model yang efisien, misi itu melibatkan masalah teknis yang sudah dikenal. Sistem yang menjalankan banyak eksperimen riset perlu menggunakan sumber daya komputasi secara efisien, dan peningkatan algoritma atau kernel dapat memungkinkan lebih banyak eksperimen dilakukan dengan anggaran tetap.
Pendanaan Discovery Loop juga menarik perhatian. Pada September, perusahaan itu dilaporkan mencari pendanaan dengan valuasi sekitar $50 miliar, dibandingkan pembicaraan bernilai sekitar $10 miliar hanya beberapa minggu sebelumnya, atau kenaikan lima kali lipat. Angka-angka tersebut menggambarkan valuasi perusahaan yang diusulkan dalam pembicaraan penggalangan dana.
Chen juga memiliki keterkaitan sebelumnya dengan Bay Area melalui Tilde Research. Pengalaman magangnya di sana membantu menjelaskan bahwa perjalanannya ke California mungkin melibatkan beberapa kontak profesional, bukan hanya satu tujuan yang jelas.
Dampak kepergiannya bagi Moonshot
Peneliti Moonshot Du Yulun, yang mendukung perekrutan Chen saat berusia 16 tahun, mengatakan bahwa mereka berdua telah beberapa kali berbincang panjang tentang keputusannya untuk pergi. Du mengungkapkan kesedihan, tetapi mendukung keinginan Chen untuk mendalami minat baru pada usianya saat ini.
Kontribusi Chen tetap menjadi bagian dari rekam jejak riset tim. Kimi K3, yang dirilis pada Juli dengan 2,8 triliun parameter, menggabungkan Attention Residuals dengan Kimi Delta Attention. Keduanya menangani bagian pemrosesan informasi yang berbeda: AttnRes mengubah cara informasi mengalir melalui kedalaman model, sedangkan KDA membantu memproses urutan secara efisien.
Moonshot mengaitkan peningkatan efisiensi penskalaan K3 sekitar 2,5 kali dibandingkan K2 dengan gabungan perubahan arsitektur, metode pelatihan, dan pilihan data. Ini menempatkan karya Chen dalam upaya perusahaan yang lebih luas, yang melibatkan banyak peneliti dan beberapa perubahan teknis.
Dampak praktisnya melampaui karier seorang karyawan yang masih sangat muda. Model yang belajar lebih efisien dapat memanfaatkan prosesor mahal dan anggaran riset dengan lebih baik. Peneliti yang mampu menghubungkan rancangan matematis dengan implementasi cepat dapat berkontribusi langsung pada tujuan tersebut.
Chen meninggalkan Moonshot dengan karya yang telah dipublikasikan, pengalaman di dua lingkungan riset, dan perhatian dari laboratorium terkemuka lainnya. Fakta yang telah dikonfirmasi sudah cukup berarti: seorang remaja membantu mengubah gagasan arsitektur menjadi metode yang dapat digunakan, lalu memilih untuk terus menjelajah sebelum mengumumkan posisi berikutnya.
Poin Utama
- Chen Guangyu, yang juga dikenal sebagai Nathan Chen, mengumumkan kepergiannya dari Moonshot AI pada 15 Oktober 2026, saat berusia 17 tahun.
- Ia berbagi kredit sebagai penulis pertama dengan kontribusi setara bersama Yu Zhang dan Jianlin Su untuk Attention Residuals, yang diterbitkan pada 16 Maret.
- Eksperimen Moonshot menunjukkan peningkatan pada semua tugas yang dievaluasi dan menyamai model dasar yang menggunakan komputasi 1,25 kali lebih besar.
- Chen membantu mengembangkan Block AttnRes dan mengerjakan percepatan perhitungan Kimi Delta Attention.
- Ia mengatakan sedang menuju Bay Area dan membantah spekulasi bahwa dirinya akan bergabung dengan Anthropic.
- Klaim bahwa ia akan bergabung dengan Discovery Loop serta spekulasi yang mengaitkannya dengan lima tawaran senilai sekitar $1 juta per tawaran belum dikonfirmasi.