Lebih banyak permintaan AI tanpa menambah GPU
Samsung Electronics mengembangkan metode untuk menangani lebih banyak permintaan serentak ke server kecerdasan buatan dengan mengubah cara server mengalokasikan memori dan memindahkan data antarprosesor. Permohonan paten yang telah dipublikasikan menjelaskan perangkat lunak yang mempertimbangkan waktu tunggu, biaya transfer, dan kebutuhan memori mendatang untuk menentukan permintaan mana yang harus diproses lebih dahulu oleh model bahasa besar.
Daftar Isi
- Lebih banyak permintaan AI tanpa menambah GPU
- Mengapa memori dapat memperlambat jawaban
- Cara kerja metode penjadwalan yang dipatenkan
- Hasil pengukuran Samsung dengan pemindahan data ke penyimpanan
- Respons lebih cepat dimulai dan lebih banyak teks dihasilkan
- Kapan biaya penyimpanan tambahan sepadan
- Penghematan daya juga mengurangi kerja kipas pendingin
- Penyimpanan harus mampu menangani lonjakan
- Samsung SDS memindahkan komputasi ke dalam memori
- Poin-Poin Utama
Tujuannya adalah mengurangi keterlambatan saat memori unit pemrosesan grafis (GPU) penuh, sehingga server yang ada dapat melayani lebih banyak orang. Samsung menjelaskan bahwa penemuan ini merupakan teknologi infrastruktur untuk inferensi AI, yakni proses menjalankan model yang telah dilatih untuk menjawab pertanyaan, bukan fitur untuk produk konsumen tertentu.
Riset Samsung terkait memberikan gambaran konkret mengenai potensi penghematan dari pengelolaan memori yang lebih baik. Dalam eksperimen penyimpanan terpisah yang menggunakan delapan GPU NVIDIA H100 NVL dan sepuluh solid-state drive Samsung, Samsung mempertahankan waktu tunggu token keluaran pertama di bawah satu detik hingga 240 pengguna serentak. Tanpa pemindahan data ke penyimpanan, waktu tunggu mulai meningkat saat jumlah pengguna melampaui 140.
Paten, eksperimen penyimpanan, dan proyek lain dari Samsung SDS menyasar berbagai bagian dari persoalan yang sama: prosesor AI yang mahal dapat menghabiskan terlalu banyak waktu untuk memindahkan atau membangun ulang informasi. Bagi operator, mengurangi pekerjaan tersebut dapat berarti lebih banyak jawaban dari perangkat yang sudah ada dan biaya lebih rendah untuk setiap token, yakni potongan kecil teks yang diproses dan dihasilkan model bahasa.
Mengapa memori dapat memperlambat jawaban
GPU menjalankan banyak kalkulasi sekaligus sehingga berguna untuk menghasilkan respons AI. Namun, kapasitas memori lokalnya yang berkecepatan tinggi terbatas. Sejumlah percakapan bersaing memperebutkan ruang tersebut, terutama ketika pengguna mengirim dokumen panjang atau mengajukan pertanyaan yang memerlukan jawaban panjang.
Model bahasa menyimpan catatan sementara dari kalkulasi sebelumnya dalam struktur yang disebut cache key-value, yang biasanya disingkat menjadi cache KV. Bayangkan struktur ini sebagai catatan kerja: dengan menyimpan catatan tersebut, model dapat melanjutkan jawaban tanpa berulang kali menghitung ulang semua yang telah diproses.
Eksperimen penyimpanan Samsung memerlukan sekitar 3 GB cache KV untuk setiap sesi. Untuk 240 sesi, jumlahnya sekitar 720 GB data cache dalam beban kerja tersebut. Angka ini membantu menjelaskan mengapa melayani banyak orang dapat menjadi persoalan memori, bahkan ketika daya komputasi yang terpasang cukup besar.
Saat memori GPU berkecepatan tinggi mulai menipis, server dapat memindahkan sebagian data ke memori yang terhubung dengan unit pemrosesan pusat (CPU), lalu mengambilnya kembali saat dibutuhkan. Transfer tersebut memerlukan waktu. Menghitung ulang kalkulasi yang telah dibuang juga menghabiskan sumber daya. Paten Samsung berfokus pada pengelolaan persaingan ini secara lebih cermat.
Cara kerja metode penjadwalan yang dipatenkan
Permohonan Samsung yang berjudul Metode dan Server untuk Memproses Beberapa Permintaan Pengguna Model Bahasa Besar menjelaskan penjadwal yang mempertimbangkan biaya untuk melayani setiap permintaan. Masukannya mencakup lama waktu pengguna menunggu, waktu yang diperlukan untuk mentransfer data, dan jumlah memori yang dibutuhkan permintaan tersebut.
Server menggunakan perhitungan itu untuk memilih urutan pemrosesan. Hal ini penting karena permintaan yang tampak siap dijalankan mungkin memerlukan transfer besar terlebih dahulu, sementara permintaan lain dapat menggunakan data yang sudah tersedia di dekatnya. Mengatur pilihan tersebut dapat mengurangi waktu yang dihabiskan untuk menata ulang memori.
Metode ini juga memeriksa apakah informasi yang sebelumnya dipindahkan ke memori CPU masih tersedia di sana. Jika salinan yang bisa digunakan tersedia, server hanya perlu memindahkan bagian yang diperlukan, alih-alih menyalin semuanya kembali. Server juga dapat mentransfer data untuk satu pengguna saat GPU menghasilkan respons pengguna lain, sehingga pekerjaan pemrosesan dan persiapan dapat berlangsung bersamaan.
Samsung juga menjelaskan penggunaan memori yang tersedia sebagian. Jika permintaan baru membutuhkan lima unit ruang, tetapi hanya tiga yang kosong, sistem dapat memulai bagian yang muat alih-alih menunggu sampai kelima unit tersedia. Tujuan praktisnya adalah menjaga agar sumber daya yang terbatas tetap produktif saat periode sibuk. Detail penerapan komersial dan peningkatan terukur dalam waktu respons serta throughput untuk metode yang dipatenkan ini belum diungkapkan.
Hasil pengukuran Samsung dengan pemindahan data ke penyimpanan
Buku putih cache KV Samsung Electronics mengkaji pendekatan lain: menyimpan data cache yang dapat digunakan kembali pada solid-state drive NVMe. NVMe adalah teknologi yang memungkinkan perangkat penyimpanan berkomunikasi cepat dengan komputer melalui koneksi PCIe.
Pengujian menggunakan delapan GPU NVIDIA H100 NVL, delapan layanan inferensi LLaMA-3.1 8B yang berjalan secara paralel, perangkat lunak layanan vLLM, serta LMCache, sebuah lapisan sumber terbuka yang mengelola data cache KV yang dapat digunakan kembali. Sepuluh drive Samsung PM1753 digabungkan dalam susunan RAID-0, yang menyebarkan data ke beberapa drive untuk meningkatkan kinerja transfer.
Samsung mengukur beban pengguna dengan kenaikan 20 pengguna, hingga mencapai 280 pengguna serentak. Setiap pengguna mengirimkan kueri setiap 20 detik, menghasilkan beban kerja mulai dari satu hingga 14 kueri per detik. Dengan demikian, eksperimen tersebut menguji pola permintaan berulang dan pemindahan cache yang telah ditentukan.
Pendekatan penyimpanan berguna ketika sebuah sesi berpindah antar-GPU. GPU tujuan dapat memuat kembali kalkulasi yang tersimpan alih-alih mengulangi pemrosesan awal atas prompt panjang. Dalam satu mesin, cache eksternal dapat disimpan di memori CPU atau penyimpanan. Untuk beberapa mesin, Samsung menjelaskan bahwa cache memerlukan sumber daya bersama yang dapat diakses oleh server terkait.
Respons lebih cepat dimulai dan lebih banyak teks dihasilkan
Samsung mengukur dua aspek kinerja layanan: waktu hingga token pertama dan jumlah token per detik. Ukuran pertama menunjukkan berapa lama seseorang menunggu sebelum jawaban mulai muncul. Ukuran kedua menunjukkan banyaknya teks yang dihasilkan sistem dalam jangka waktu tertentu.
Dengan pemindahan data ke penyimpanan diaktifkan, pengujian mempertahankan waktu hingga token pertama di bawah satu detik hingga 240 pengguna serentak, dibandingkan dengan peningkatan latensi setelah jumlah pengguna melampaui 140 tanpa pemindahan data. Samsung menyebutnya sebagai kemampuan melayani 1,7 kali lebih banyak pengguna dengan latensi yang sebanding. Untuk kisaran 20 hingga 140 pengguna, konfigurasi yang menggunakan pemindahan data menjaga waktu tunggu awal sekitar setengah detik.
Pada 240 pengguna, sistem dengan pemindahan data menghasilkan sekitar 1,5 kali lebih banyak token keluaran. Konfigurasi tanpa pemindahan data mulai mencapai batas kapasitas di sekitar 160 pengguna, sementara sistem yang menggunakan kembali cache tersimpan terus meningkatkan keluarannya seiring bertambahnya permintaan.
Samsung mengaitkan peningkatan tersebut dengan berkurangnya pemrosesan prompt yang berulang. Model bahasa terlebih dahulu memproses masukan, tahap yang dikenal sebagai prefill, lalu menghasilkan respons token demi token dalam tahap yang disebut decode. Penggunaan kembali kalkulasi yang tersimpan menyisakan lebih banyak kapasitas GPU untuk menghasilkan jawaban.
Kapan biaya penyimpanan tambahan sepadan
Analisis biaya Samsung menunjukkan bahwa perangkat keras tambahan tetap memiliki harga, meskipun meningkatkan efisiensi saat permintaan tinggi. Untuk kisaran nol hingga 160 pengguna serentak, kedua konfigurasi menghasilkan throughput token yang serupa, sementara konfigurasi dengan pemindahan data berbiaya sekitar 4% lebih tinggi karena tambahan komponen NVMe.
Di atas 180 pengguna, peningkatan keluaran mengimbangi biaya penyimpanan tambahan tersebut. Pada 240 pengguna, Samsung menghitung efisiensi biaya sekitar 1,5 kali lebih baik, diukur berdasarkan jumlah token per detik per dolar selama masa operasi tiga tahun.
Dengan kata lain, peningkatan keluaran per dolar sebesar 1,5 kali setara dengan biaya per unit keluaran yang sekitar sepertiganya lebih rendah berdasarkan perhitungan tersebut. Perbandingan ini mengacu pada perangkat dan beban kerja yang diuji Samsung. Biaya aktual suatu layanan juga bergantung pada model, panjang percakapan, lalu lintas, dan biaya perangkat.
Bagi operator cloud, pilihan praktisnya karena itu sangat bergantung pada permintaan. Penyimpanan tambahan dapat menaikkan biaya awal ketika kapasitas GPU yang ada sudah mampu menangani beban kerja dengan mudah. Saat kemacetan berlangsung terus-menerus, penggunaan kembali cache dapat membuat instalasi GPU yang sama menangani lebih banyak aktivitas sebelum server tambahan diperlukan.
Penghematan daya juga mengurangi kerja kipas pendingin
Samsung juga mengukur penurunan konsumsi listrik dalam eksperimen penyimpanannya. Pada 240 pengguna, kinerja per watt meningkat sekitar 2,9 kali. Daya total sistem turun hingga kira-kira 53% dari konfigurasi tanpa pemindahan data, atau berkurang sekitar 47%.
Menurut buku putih tersebut, tambahan drive NVMe meningkatkan konsumsi daya sekitar 6%. Penurunan kebutuhan daya GPU dan pendinginan lebih dari cukup untuk mengimbangi kenaikan itu. Samsung mencatat pemanfaatan GPU sekitar 49% saat beban kerja beralih dari pengulangan kalkulasi prefill yang intensif.
Perubahan tersebut juga terlihat pada kipas pendingin. Tanpa pemindahan data, semua kipas sistem beroperasi pada kecepatan maksimum yang diperkirakan, yaitu 15.000 putaran per menit. Dengan pemindahan data, kipas untuk CPU, memori, dan penyimpanan berputar sekitar 7.800 putaran per menit, sedangkan kipas di sisi GPU berputar sekitar 9.800 putaran per menit.
Hasil ini menunjukkan mengapa suatu komponen dapat menambah kebutuhan listrik secara lokal sekaligus mengurangi konsumsi di seluruh server. Dalam eksperimen ini, energi yang digunakan untuk mengambil kembali kalkulasi tersimpan mengurangi pengeluaran energi yang lebih besar untuk mengulang kalkulasi dan membuang panas yang dihasilkan.
Penyimpanan harus mampu menangani lonjakan
Pengukuran Samsung juga menunjukkan bahwa pendekatan ini membutuhkan lebih dari sekadar kapasitas drive yang tersisa. Throughput penyimpanan agregat rata-rata mencapai hingga 37 GB per detik, sementara permintaan GPU serentak dapat mendorong kebutuhan puncak hingga hampir dua kali lipat dari rata-rata.
Jumlah operasi penyimpanan yang sedang berlangsung biasanya sekitar 160, tetapi dapat melonjak hingga 800. Samsung merekomendasikan bandwidth penyimpanan setidaknya dua kali kebutuhan rata-rata agar lonjakan tersebut dapat ditangani tanpa mengurangi responsivitas.
PM1753 memiliki spesifikasi throughput sekuensial hingga 14,5 GB per detik dan 3,3 juta operasi baca acak per detik. Dalam beban kerja yang diuji, operasi baca mencakup sekitar 92% aktivitas penyimpanan, sementara operasi tulis sebesar 8%. LMCache memindahkan blok cache besar berukuran sekitar 33 MB.
Beberapa layanan yang membaca blok besar secara bersamaan dapat menghasilkan aliran permintaan yang saling berselang-seling. Karena itu, subsistem penyimpanan perlu mempertahankan kinerja transfer saat banyak pengguna aktif bersamaan. Kapasitas cache, kecepatan transfer, dan penjadwalan turut menentukan apakah informasi tersimpan dapat mencapai GPU cukup cepat untuk digunakan.
Samsung SDS memindahkan komputasi ke dalam memori
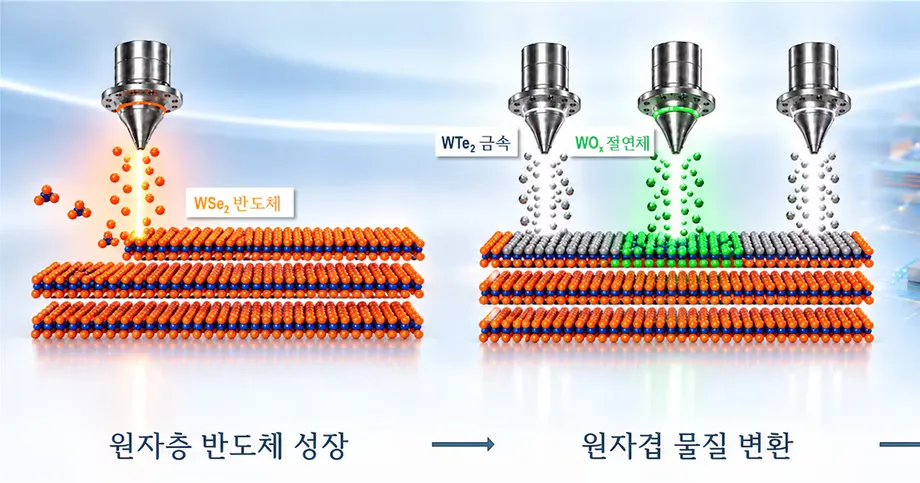
Samsung SDS menangani pemindahan data melalui pendekatan lain. Uraian riset PAISE menjelaskan PIM-Accelerated Inference Scheduling Engine, yang dipresentasikan di IEEE HPCA 2025. PAISE menggunakan pemrosesan dalam memori (PIM), yaitu teknologi yang menempatkan unit komputasi di dalam cip memori agar sebagian kalkulasi dapat dilakukan di tempat data disimpan.
Samsung SDS menerapkan dan memvalidasi sistem tersebut pada perangkat keras PIM Aquabolt-XL milik Samsung, dengan mengevaluasi model GPT-2, OPT, dan Llama2. Perusahaan melaporkan peningkatan kecepatan inferensi hingga 48,3% dan penurunan konsumsi daya sekitar 11,5%.
PAISE menentukan operasi mana yang sebaiknya dijalankan di dalam memori dan menata data agar sesuai dengan perangkat keras. Sistem ini juga mengelompokkan kalkulasi atensi berukuran kecil agar dapat dijalankan secara paralel dengan lebih efisien. Samsung SDS melaporkan pembaruan cache KV yang lebih cepat dan peningkatan lebih besar pada ukuran batch yang lebih besar, yakni kelompok permintaan yang diproses bersama.
Ketiga proyek ini bekerja pada bagian server yang berbeda. Paten menjadwalkan permintaan dan transfer antara memori GPU dan CPU. Eksperimen penyimpanan mempertahankan cache di drive untuk digunakan kembali nanti. PAISE memindahkan kalkulasi tertentu ke perangkat keras memori. Secara keseluruhan, proyek-proyek ini menunjukkan upaya Samsung mencari berbagai cara untuk mengurangi waktu dan energi yang dihabiskan untuk memindahkan atau membangun ulang informasi di balik respons AI.
Poin-Poin Utama
- Permohonan paten Samsung yang telah dipublikasikan menjadwalkan permintaan AI dengan mempertimbangkan waktu tunggu, biaya transfer, dan perkiraan kebutuhan memori.
- Metode yang dipatenkan bertujuan melayani lebih banyak pengguna dengan GPU yang sudah ada; angka kinerja komersial belum diungkapkan.
- Dalam pengujian penyimpanan terpisah, Samsung melayani 240 pengguna serentak dengan waktu tunggu respons awal di bawah satu detik, dibandingkan dengan peningkatan latensi setelah jumlah pengguna melampaui 140 tanpa pemindahan data.
- Pada 240 pengguna, pemindahan data ke penyimpanan menghasilkan sekitar 1,5 kali lebih banyak token dan efisiensi biaya yang lebih baik, disertai peningkatan kinerja per watt sebesar 2,9 kali.
- Penyimpanan tambahan menaikkan biaya sekitar 4% pada beban ringan, sehingga tingkat permintaan menjadi faktor penting dalam perhitungan ekonomi.
- Samsung SDS melaporkan bahwa sistem PAISE yang terpisah meningkatkan kecepatan inferensi hingga 48,3% dengan menjalankan komputasi di dalam memori.