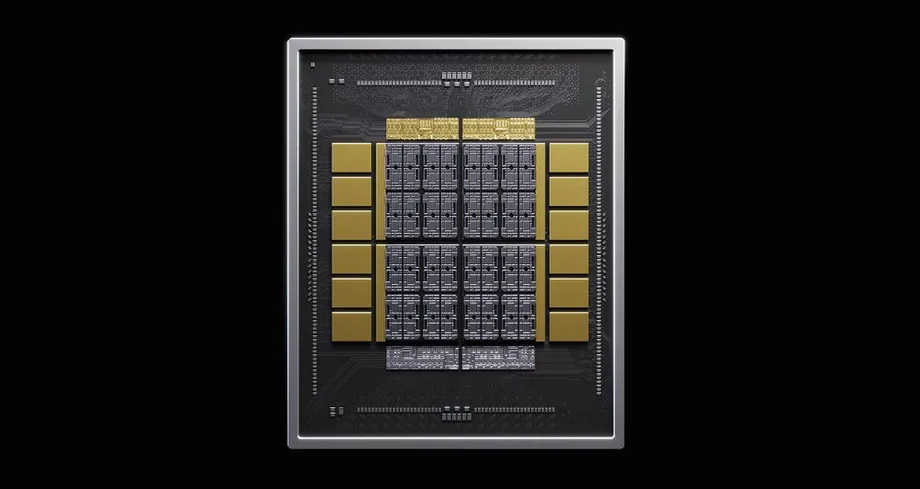
Resep manufaktur bersama untuk tiga pemasok memori
Nvidia meminta Samsung Electronics, SK hynix, dan Micron menggunakan proses manufaktur 3nm TSMC untuk base die pada generasi berikutnya dari high bandwidth memory kustom mereka, menurut laporan industri yang diterbitkan pada 18 Oktober 2026. Divisi Device Solutions Samsung dikabarkan menerima permintaan itu setelah peninjauan internal, sehingga pesaingnya di bidang foundry Taiwan dilibatkan dalam bagian manufaktur memori yang selama ini secara tradisional ditangani Samsung sendiri.
Daftar Isi
- Resep manufaktur bersama untuk tiga pemasok memori
- Apa yang berubah di dalam tumpukan memori?
- Mengapa Nvidia menginginkan proses yang sama di semua pemasok
- Samsung tetap mengandalkan pabriknya sendiri
- Micron dan SK hynix menempuh jalur berbeda
- Arti angka kinerja Nvidia
- Amazon menghubungkan memori dengan platform Nvidia yang lebih luas
- Perkembangan langkah ini
- Poin Utama
Produk yang disebut NVHBM ini berbasis HBM4E, generasi ketujuh high bandwidth memory. Nvidia juga ingin para pemasok menggunakan teknologi manufaktur DRAM generasi keenam untuk die memori, yang disebut 1c. Tujuannya adalah membuat memori dari pemasok yang berbeda berperilaku lebih konsisten dan mengurangi pekerjaan rekayasa yang diperlukan untuk menyetujui produk setiap pemasok.
Keputusan Samsung akan memperluas hubungan yang sudah terjalin dengan TSMC, dari kompatibilitas pengemasan hingga manufaktur HBM. Empat tahun sebelumnya, kedua perusahaan bekerja sama untuk memastikan memori Samsung dapat terhubung ke prosesor grafis melalui teknologi pengemasan TSMC. Produksi chip penting di dalam tumpukan memori membawa kerja sama itu lebih jauh.
Usulan Nvidia juga mengubah fungsi base die. NVHBM memindahkan pengontrol memori, yakni sirkuit yang mengarahkan aliran data, dari prosesor utama ke bagian bawah tumpukan memori. Dengan demikian, base die menjadi bagian yang lebih penting dalam sistem komputasi, bukan sekadar penghubung antara memori dan prosesor.
Bagi Samsung, menerima arsitektur tersebut berarti memisahkan dua keputusan yang sebelumnya ditangani bersamaan: siapa yang membuat memori untuk menyimpan informasi dan siapa yang memproduksi chip logika yang mengatur koneksinya ke prosesor. Samsung akan tetap memasok memori, sementara TSMC memproduksi base die sesuai spesifikasi.
Apa yang berubah di dalam tumpukan memori?
HBM menempatkan beberapa die memori bertumpuk di samping prosesor berperforma tinggi. Desain bertumpuk ini memungkinkan data dalam jumlah besar berpindah melalui jarak pendek, sehingga membantu akselerator AI memasok informasi ke unit komputasinya. Die adalah satu keping silikon yang berisi sirkuit elektronik.
Die inti menyimpan data. Base die berada di bawahnya dan menangani koneksi serta fungsi logika. Dalam susunan konvensional, pengontrol memori tetap berada di die akselerator utama. NVHBM memindahkan pengontrol tersebut ke base die, sehingga ruang di prosesor dapat digunakan untuk sirkuit lain.
Nvidia juga menggunakan antarmuka fisik kustom yang dikenal sebagai PHY untuk menghubungkan chip-chip tersebut. PHY adalah sirkuit yang mengirim dan menerima sinyal listrik. Deskripsi teknis NVHBM menyebutkan bahwa teknologi ini mengganti antarmuka paralel lebar yang terkait dengan HBM standar dengan koneksi serial yang lebih sempit dan eksklusif, yang mengirimkan data melalui lebih sedikit koneksi dengan kecepatan lebih tinggi.
Skala antarmuka konvensional membantu menjelaskan daya tarik teknologi ini. HBM4 memiliki 32 kanal, masing-masing selebar 64 bit, sehingga total lebarnya mencapai 2.048 bit. Pengelolaan koneksi tersebut membutuhkan sirkuit yang besar dan pengawatan kompleks antarchip. NVHBM dirancang untuk mengurangi beban itu dan menyederhanakan pengaturan jalur koneksi pada interposer, lapisan penghubung di bawah chip.
Nvidia menawarkan NVHBM sebagai blok penyusun bagi mitra silikon kustom melalui NVLink Fusion. HBM standar tetap menjadi kategori produk terpisah. Mitra yang memilih NVHBM akan menggunakan desain pengontrol dan koneksi yang ditentukan Nvidia sebagai bagian dari sistem akselerator mereka.
Mengapa Nvidia menginginkan proses yang sama di semua pemasok
Resep manufaktur yang diusulkan Nvidia menggabungkan proses logika 3nm TSMC dengan proses DRAM canggih untuk lapisan memori. Logika dan DRAM memiliki fungsi berbeda dan menggunakan metode manufaktur yang berbeda. Label 3nm menunjukkan generasi manufaktur logika, sedangkan 1c menunjukkan generasi teknologi DRAM.
Samsung, SK hynix, dan Micron masing-masing memiliki desain dan metode produksi sendiri. Perbedaan tersebut dapat mengharuskan pengujian tambahan ketika pengembang akselerator ingin membeli memori dari lebih dari satu perusahaan. Proses base die yang sama memberi pengembang titik awal yang lebih konsisten.
Validasi berarti memeriksa apakah prosesor, memori, dan kemasan berfungsi bersama pada kecepatan, tingkat daya, dan keandalan yang ditargetkan. Mengulangi proses tersebut untuk penerapan yang berbeda membutuhkan waktu rekayasa. Usulan Nvidia berupaya mengurangi pekerjaan integrasi terpisah yang diperlukan saat berganti pemasok memori.
Micron menyebut generasi DRAM mendatangnya 1-gamma, yang secara umum sebanding dengan generasi 1c dalam istilah yang digunakan Samsung dan SK hynix. Dengan demikian, sasaran terpadu ini menyatukan generasi manufaktur yang memiliki nama berbeda di tiap perusahaan, bukan membuat proses memori semua pemasok menjadi identik.
TSMC akan menjadi mitra manufaktur bersama di balik produk memori dari perusahaan-perusahaan yang bersaing. Pengaturan ini dapat menyederhanakan penerapan Nvidia di berbagai pemasok, sekaligus memusatkan satu tahap produksi penting di satu foundry. Peninjauan Samsung terhadap jalur manufaktur cadangan mencerminkan pentingnya ketersediaan base die yang memadai.
Samsung tetap mengandalkan pabriknya sendiri
Samsung berencana mempertahankan model manufaktur terintegrasi untuk HBM standar. Produk HBM4 dan HBM4E-nya menggunakan proses 4nm Samsung sendiri untuk base die dan proses 1c untuk die inti. Lapisan memori diproduksi di kampusnya di Hwaseong dan Pyeongtaek, Korea Selatan.
Samsung memulai produksi massal HBM4 pada awal 2026, sedangkan HBM4E sedang menjalani kualifikasi produksi massal saat laporan Oktober tersebut diterbitkan. Kualifikasi adalah tahap pengujian untuk memastikan suatu produk siap diproduksi secara konsisten sesuai standar yang ditetapkan.
HBM kustom untuk pelanggan lain, termasuk AMD, juga diperkirakan tetap menggunakan pendekatan terintegrasi Samsung. Karena itu, keputusan NVHBM khusus untuk memenuhi kebutuhan Nvidia, bukan perubahan menyeluruh di perusahaan untuk berhenti membuat base die sendiri.
Divisi Memory Business Samsung diperkirakan akan memimpin dukungan desain dan optimalisasi untuk base die yang diproduksi TSMC. Hal itu akan mengubah pembagian tanggung jawab di Samsung, tempat System LSI dan bisnis Foundry secara tradisional berkontribusi pada base die yang dipasok secara internal.
Samsung juga sedang menilai apakah foundry-nya sendiri dapat memproduksi base die NVHBM jika permintaan melampaui kapasitas TSMC. Jalur cadangan yang diusulkan akan mempertahankan opsi produksi lain, meskipun spesifikasi Nvidia yang dilaporkan saat ini berfokus pada proses 3nm TSMC.
Micron dan SK hynix menempuh jalur berbeda
Perubahan Micron mencakup lebih dari sekadar produk kustom Nvidia. Perusahaan itu menyatakan bahwa NVHBM, yang dikembangkan bersama Nvidia, dan HBM4E standar akan menggunakan base die yang diproduksi oleh foundry eksternal. TSMC diperkirakan menangani manufaktur tersebut.
Untuk HBM4, Micron memasangkan die memori yang dibuat dengan proses 1-beta dengan base die yang diproduksi sendiri. Pada HBM4E, lapisan memori beralih ke 1-gamma dan produksi base die dialihkan ke luar pabrik Micron. Dengan demikian, Micron mengubah kedua bagian utama tumpukan, menggunakan proses memori yang lebih baru sekaligus mengadopsi mitra manufaktur logika eksternal.
Chief Operating Officer Micron Manish Bhatia memperkirakan NVHBM akan meraih harga jual rata-rata yang lebih tinggi dan margin yang lebih kuat. Menurutnya, HBM sudah dijual dengan harga premium, sementara pekerjaan dan fungsi tambahan dalam kustomisasi menciptakan nilai lebih besar. Karena itu, produksi base die secara alih daya tetap dapat sejalan dengan ekspektasi peningkatan profitabilitas.
SK hynix sudah menggunakan proses logika 12nm TSMC untuk base die HBM4. Laporan industri menunjukkan proses 3nm TSMC diprioritaskan untuk HBM4E dan HBM kustom mendatang. Langkah ini akan menghadirkan manufaktur logika yang lebih canggih pada komponen yang memikul tanggung jawab tambahan.
SK hynix juga telah memperkenalkan konsep HBM kustom berbasis teknologi Stream DQ dalam acara GTC Nvidia pada awal tahun. Konsep tersebut berfokus pada pengelolaan dan penyaluran data secara berkelanjutan ke prosesor. Ketiga pemasok sama-sama bergerak ke arah menjadikan base die lebih aktif dalam memindahkan data.
Arti angka kinerja Nvidia
Nvidia menyatakan NVHBM dapat memberikan bandwidth hingga 30% lebih besar per tumpukan dibandingkan HBM4E standar dan menggunakan daya HBM 15% lebih rendah. Bandwidth mengukur jumlah data yang dapat dipindahkan dalam kurun waktu tertentu. Bandwidth yang lebih besar dapat membantu prosesor AI yang sedang menunggu informasi dari memori.
Dalam perbandingan sederhana, jika satu tumpukan HBM4E standar mengirimkan 100 unit data dalam periode tertentu, peningkatan maksimum yang diklaim Nvidia akan menaikkannya menjadi 130 unit. Jika memori pembanding menggunakan daya 100 unit, pengurangan yang diklaim akan menurunkan konsumsi HBM menjadi 85 unit. Contoh ini menggambarkan persentasenya, bukan produk tertentu yang sudah dipasarkan.
Nvidia juga menyebut dapat membebaskan hingga 25% area die komputasi XPU. XPU adalah istilah luas untuk prosesor komputasi, termasuk akselerator AI kustom. Memindahkan sirkuit memori memberi perancang ruang untuk mengalokasikan lebih banyak silikon bagi fungsi komputasi.
Laporan lain tentang presentasi Nvidia menyebut angka hingga 30% lebih banyak komputasi pada die utama. Angka itu mengukur potensi sumber daya komputasi, sedangkan angka 25% menggambarkan area silikon yang tersedia setelah perubahan arsitektur. Perancang tetap harus menentukan bagaimana ruang yang diperoleh kembali akan digunakan.
PHY kustom disebut dapat mengurangi area yang ditempati antarmuka tersebut hingga 67%. Penilaian teknis menghitung perkiraan itu berdasarkan berkurangnya jumlah pin. Perbandingan Nvidia yang lebih luas mengenai bandwidth, daya, dan area menggunakan HBM4E standar sebagai acuan, pada saat generasi tersebut belum dipasarkan.
Bagi layanan AI, perpindahan data yang lebih cepat dapat membantu menghasilkan respons dengan lebih cepat ketika memori menjadi faktor pembatas. Konsumsi daya memori yang lebih rendah dapat memberi perancang sistem ruang lebih besar dalam batas anggaran listrik. Dampaknya pada server secara keseluruhan juga bergantung pada prosesor, beban kerja, jaringan, dan pendinginan, selain memori.
Amazon menghubungkan memori dengan platform Nvidia yang lebih luas
Annapurna Labs milik Amazon adalah mitra NVHBM pertama yang diumumkan. Bisnis desain chip tersebut mengembangkan akselerator Trainium untuk Amazon Web Services, sehingga Nvidia memiliki jalur untuk memasok teknologi memori kepada perusahaan yang juga membangun prosesor AI sendiri.
Nafea Bshara, wakil presiden di Annapurna Labs, menjelaskan tujuan kemitraan itu dalam pernyataan yang menyertai pengumuman:
Kami menantikan kolaborasi teknologi ini untuk mendukung desain infrastruktur AWS mendatang.
Trainium 4 milik Annapurna diperkirakan akan mendukung NVLink Fusion. Laporan mengenai peluncuran NVHBM menyebut teknologi ini akan diperkenalkan bersama Trainium 4 atau pada generasi berikutnya; generasi chip yang tepat dan tanggal ketersediaan komersial penerapan NVHBM oleh Amazon belum diumumkan secara pasti.
NVLink Fusion memberi mitra akses ke teknologi seperti NVLink Chiplet, NVLink-C2C, NVLink Switch, serta sistem dan rak MGX. Teknologi tersebut menyediakan koneksi dan desain sistem untuk mengintegrasikan prosesor kustom ke infrastruktur komputasi Nvidia. NVHBM menambahkan subsistem memori ke dalam rangkaian tersebut.
MediaTek dikabarkan mengadopsi NVLink Fusion lima hari setelah pengumuman NVHBM dan berencana menawarkannya kepada pelanggan XPU sendiri. Ini memberi Nvidia jalur lain untuk memasuki proyek akselerator kustom, pasar tempat Broadcom dan Marvell juga bersaing. Marvell telah menjelaskan pendekatan sebanding untuk memindahkan kendali memori pada Desember 2024, sehingga adopsi pelanggan dan integrasi sistem menjadi bagian penting dalam persaingan.
Perkembangan langkah ini
Pengembangan NVHBM menyatukan perubahan arsitektur, hubungan pemasok, dan adopsi pelanggan. Urutan waktunya membantu menjelaskan pentingnya keputusan Samsung pada Oktober: Nvidia lebih dulu memaparkan desain bersama, lalu produsen memori harus memutuskan cara membangunnya.
- Desember 2024: Marvell merinci konsep sebanding yang melibatkan penempatan fungsi kendali memori yang berbeda.
- Awal 2026: Samsung memulai produksi massal HBM4, sementara SK hynix memperkenalkan konsep HBM kustom Stream DQ di GTC.
- 26 Agustus 2026: Nvidia mengumumkan NVHBM sebagai tambahan untuk NVLink Fusion dan menyebut Annapurna Labs sebagai mitra pertamanya.
- Lima hari kemudian: MediaTek dikabarkan mengadopsi NVLink Fusion dan berencana menyediakannya bagi pelanggan XPU.
- 18 Oktober 2026: Laporan industri mengungkap permintaan Nvidia untuk base die 3nm TSMC dan penerimaan Samsung setelah peninjauan internal.
Keputusan Samsung membawa rencana manufaktur lebih dekat ke tujuan Nvidia untuk menghadirkan penerapan yang konsisten di berbagai pemasok memori. Di saat yang sama, investasi berkelanjutan Samsung pada base die produksinya sendiri mempertahankan jalur berbeda untuk HBM standar dan produk kustom yang dipasok kepada pelanggan lain.
Poin Utama
- Nvidia dikabarkan ingin Samsung, SK hynix, dan Micron menggunakan proses 3nm TSMC untuk base die NVHBM.
- NVHBM memindahkan pengontrol memori dari prosesor utama ke base die dalam tumpukan HBM.
- Samsung menerima permintaan tersebut, tetapi berencana mempertahankan manufaktur internal untuk HBM standar dan produk kustom lainnya.
- Micron berencana memproduksi base die secara eksternal untuk NVHBM dan HBM4E standar; SK hynix sudah bekerja sama dengan TSMC untuk HBM4.
- Nvidia mengklaim bandwidth hingga 30% lebih besar dan konsumsi daya HBM 15% lebih rendah dibandingkan HBM4E standar.
- Annapurna Labs milik Amazon adalah mitra pertama yang diumumkan, sementara Samsung sedang menilai foundry-nya sendiri sebagai opsi cadangan produksi.