Model yang mempelajari huruf RNA dan keterkaitannya
Para peneliti di University of Science and Technology of China telah merilis structRFM, model fondasi RNA terbuka yang dilatih menggunakan 21 juta pasang sekuens RNA dan struktur yang dianotasi secara komputasional. Rilis ini mencakup data pelatihan berpasangan, bobot model, dan kode sumber, sehingga laboratorium lain dapat mereproduksi penelitian tersebut dan mengadaptasi sistemnya.
Daftar Isi
- Model yang mempelajari huruf RNA dan keterkaitannya
- Mengapa pelipatan sama pentingnya dengan sekuens
- Bagaimana 21 juta pasang data pelatihan disusun
- Melatih model dengan informasi tersembunyi
- Hasil pengujian struktur
- Dari pemrosesan RNA hingga klasifikasi fungsional
- Manfaat rilis terbuka bagi peneliti
- Tim dan linimasa publikasi
- Dampak hasil penelitian terhadap riset RNA
- Poin Utama
Studi yang diterbitkan Nature pada 4 November 2026 ini menguraikan model yang mempelajari urutan komponen penyusun molekul RNA sekaligus keterkaitan yang membantu molekul tersebut melipat. Adaptasinya untuk memprediksi struktur tiga dimensi, yang disebut Zfold, mencapai kinerja yang menurut para penulis sebanding dengan AlphaFold3 dalam evaluasi CASP15-natural, CASP16, dan RNA-Puzzles.
Keunggulan praktisnya adalah structRFM hanya membutuhkan sekuens RNA sebagai masukan setelah dilatih. Model ini menghasilkan informasi yang dapat dimanfaatkan peneliti untuk sejumlah tugas, termasuk memprediksi struktur molekul, mengidentifikasi lokasi yang terlibat dalam pemrosesan RNA, dan mengklasifikasikan molekul RNA berdasarkan fungsinya.
Makalah penelitian structRFM di Nature menyajikan karya ini sebagai cara untuk memanfaatkan pengetahuan struktural dalam berbagai tugas prediksi. Peng Xiong dan S. Kevin Zhou adalah penulis korespondensi, sementara Heqin Zhu merupakan penulis pertama.
Mengapa pelipatan sama pentingnya dengan sekuens
RNA berperan dalam produksi protein, pengaturan gen, dan pemrosesan pesan genetik. Sekuensnya adalah urutan nukleotida, unit molekuler yang umumnya dilambangkan dengan huruf A, U, C, dan G. Urutan itu membawa informasi, sedangkan cara molekul melipat turut menentukan fungsinya.
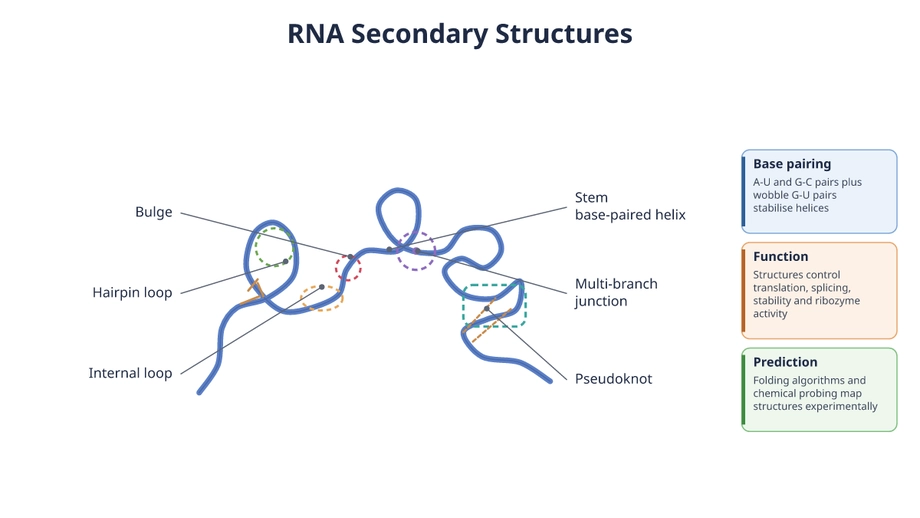
Bagian-bagian untai RNA dapat berpasangan dengan bagian lain pada untai yang sama. Keterkaitan ini membentuk struktur sekunder, yaitu pola wilayah berpasangan, batang, dan lengkungan. Molekul kemudian melipat menjadi bentuk tiga dimensi yang dikenal sebagai struktur tersier, yang memengaruhi aktivitasnya dan interaksinya dengan molekul lain.
Banyak model bahasa RNA mempelajari pola dari kumpulan sekuens berukuran besar, mirip dengan cara model bahasa mempelajari hubungan antarkata. structRFM menambahkan informasi tentang nukleotida yang berpasangan selama pelatihan, sehingga model dapat mempelajari keterkaitan antara posisi-posisi yang mungkin berjauhan dalam sekuens.
Para peneliti berupaya mempertahankan fleksibilitas model fondasi: sistem yang dilatih secara luas dan fitur yang dipelajarinya dapat diadaptasi untuk berbagai keperluan. Mereka bertujuan memasukkan informasi pelipatan ke dalam fondasi bersama tersebut, alih-alih melatih sistem yang hanya berguna untuk satu tugas struktural.
Bagaimana 21 juta pasang data pelatihan disusun
Tim tersebut menyusun set data yang terdiri atas sekitar 21 juta pasang sekuens RNA dan struktur sekundernya. Anotasi struktural dihasilkan secara komputasional, sehingga para peneliti dapat melatih model dalam skala yang jauh lebih besar dibandingkan kumpulan yang hanya berisi struktur hasil eksperimen laboratorium.
Prediksi komputer dapat mengandung kesalahan dan mencerminkan kelebihan maupun kekurangan metode yang menghasilkannya. Untuk mengurangi ketergantungan pada satu prediktor, para peneliti memperkenalkan MUSES, metode ensemble struktur sekunder dari berbagai sumber. Ensemble menggabungkan informasi dari beberapa sumber prediksi, alih-alih sepenuhnya mengandalkan satu sumber.
MUSES mengatasi masalah utama dalam melatih model menggunakan struktur hasil prediksi: kesalahan berulang dalam anotasi pelatihan dapat membentuk apa yang dipelajari model. Penggabungan prediksi struktural dirancang untuk mengurangi bias prediktor sekaligus mempertahankan informasi berguna tentang pasangan basa.
Sumber daya pelatihan dan evaluasi dalam studi ini mengambil data dari koleksi biologi yang telah mapan, termasuk RNAcentral, Rfam, dan Protein Data Bank. Pernyataan data penelitian tersebut menyebutkan rilis yang relevan, termasuk RNAcentral versi 24.0 serta Rfam versi 14.10 dan 15.0, sehingga peneliti dapat melacak set data yang digunakan dalam eksperimen.
Melatih model dengan informasi tersembunyi
structRFM menggunakan pemodelan bahasa bermasker, yaitu metode pelatihan yang menyembunyikan sebagian masukan agar model belajar memulihkan informasi yang hilang berdasarkan konteks di sekitarnya. Untuk RNA, ini berarti mempelajari hubungan antarnukleotida, bukan antarkata.
Tim tersebut memasukkan pasangan basa ke dalam proses ini melalui operasi pencocokan pasangan. Rasio masking dinamis menyeimbangkan pelatihan yang dipandu keterkaitan struktural dengan masking pada posisi nukleotida individual. Dengan demikian, model berkesempatan mempelajari pola sekuens lokal sekaligus hubungan yang terkait dengan pelipatan.
Model yang dihasilkan menyediakan tiga jenis fitur: informasi tentang sekuens secara keseluruhan, informasi tentang setiap nukleotida, dan informasi tentang pasangan nukleotida. Fitur adalah representasi numerik yang dapat digunakan sistem prediksi lain. Tugas yang berbeda dapat memanfaatkan tingkat representasi yang berbeda.
Para peneliti juga melakukan eksperimen ablasi, yaitu menghilangkan atau mengubah bagian-bagian model untuk menguji kontribusinya. Hasil eksperimen tersebut mendukung kontribusi informasi struktural maupun strategi masking terhadap peningkatan yang dilaporkan, sekaligus memberikan bukti atas pilihan desain structRFM.
Hasil pengujian struktur
structRFM menunjukkan kinerja kuat dalam klasifikasi homologi zero-shot. Homologi berkaitan dengan hubungan yang diwariskan dari asal evolusi yang sama. Dalam konteks ini, klasifikasi zero-shot menguji kegunaan representasi yang dipelajari untuk mengenali hubungan semacam itu tanpa pelatihan khusus pada tugas klasifikasi yang menjadi sasaran.
Para penulis juga melaporkan peningkatan prediksi struktur sekunder dan kinerja kuat pada famili RNA yang baru dirilis. Famili RNA mengelompokkan molekul-molekul terkait yang memiliki fitur sekuens atau struktur yang sama. Pengujian pada famili yang baru dirilis mengukur kinerja model di luar kelompok yang sudah dikenal dan tercakup dalam set data mapan.
Untuk memprediksi struktur tersier, tim tersebut mengembangkan Zfold dengan mengadaptasi fitur yang dipelajari structRFM menjadi model yang memprediksi bentuk tiga dimensi. Para penulis melaporkan peningkatan pada bentuk yang diprediksi maupun struktur sekunder yang diperoleh dari prediksi tersebut.
Zfold dievaluasi menggunakan CASP15-natural, CASP16, dan RNA-Puzzles, kumpulan tolok ukur yang digunakan untuk menilai prediksi struktur molekul. Dalam seluruh evaluasi tersebut, makalah ini menyebut kinerjanya sebanding dengan AlphaFold3. Perbandingan tersebut merujuk pada hasil Zfold di tolok ukur yang disebutkan, sementara structRFM menyediakan representasi RNA yang mendasarinya.
Studi ini menyajikan beberapa jenis keberhasilan, bukan satu skor akurasi yang mencakup semua penggunaan. Mengenali sekuens terkait, memprediksi pasangan basa, dan merekonstruksi bentuk tiga dimensi merupakan masalah yang berbeda dan masing-masing memerlukan evaluasi tersendiri.
Dari pemrosesan RNA hingga klasifikasi fungsional
structRFM juga diuji pada tugas yang berkaitan dengan fungsi RNA. Pengujian tersebut mencakup prediksi lokasi penyambungan, identifikasi situs masuk ribosom internal, dan klasifikasi RNA nonpengode, sehingga evaluasi melampaui bentuk molekul.
Situs penyambungan menandai batas yang digunakan saat sel memproses pesan RNA. Dalam proses penyambungan, bagian-bagian tertentu dihilangkan dan bagian yang tersisa disatukan. Memprediksi batas tersebut membantu peneliti memeriksa bagaimana pesan genetik dirangkai sebelum digunakan untuk membuat protein.
Situs masuk ribosom internal, atau elemen IRES, adalah wilayah RNA yang memungkinkan perangkat seluler pembuat protein memulai translasi dari bagian dalam. Untuk mengidentifikasinya, perlu dikenali pola fungsional dalam sekuens. Karena itu, tugas ini menjadi pengujian lain terhadap informasi yang ditangkap selama prapelatihan.
RNA nonpengode menjalankan fungsi selain menjadi cetakan untuk produksi protein. Mengklasifikasikannya berarti mengelompokkan molekul ke dalam kategori yang sesuai. Para penulis melaporkan peningkatan kinerja pada berbagai tugas fungsional ini, yang menunjukkan bahwa representasi yang dipelajari tetap berguna ketika sasaran prediksi beralih dari struktur ke peran biologis.
Tim tersebut juga memperluas model untuk klasifikasi RNA nonpengode panjang menggunakan strategi segmentasi. Membagi sekuens panjang menjadi beberapa bagian memungkinkan model diterapkan pada masukan yang jika tidak demikian akan sulit diproses sebagai satu kesatuan.
Manfaat rilis terbuka bagi peneliti
Rilis ini mencakup tiga sumber daya dengan kegunaan berbeda. Set data menyediakan contoh yang digunakan untuk pembelajaran. Bobot model memuat nilai numerik yang dipelajari selama pelatihan. Kode sumber menjelaskan implementasi dan cara menjalankan perangkat lunak.
Akses ke bobot memungkinkan peneliti menggunakan model yang sudah dilatih tanpa perlu mengulangi seluruh proses prapelatihan. Akses ke data dan kode mendukung pemeriksaan lebih mendalam terhadap prosedur pelatihan, reproduksi eksperimen, dan pengembangan pendekatan alternatif.
Makalah tersebut menyebut repositori proyek heqin-zhu/structRFM di GitHub. Makalah ini juga mencantumkan arsip Zenodo untuk set data prapelatihan dengan DOI 10.5281/zenodo.18272040 serta arsip kode sumber dan pos pemeriksaan model dengan DOI 10.5281/zenodo.18274292. DOI adalah pengenal permanen yang dirancang agar sumber daya penelitian dapat dilacak dari waktu ke waktu.
Pernyataan data menyebutkan bahwa set data pelatihan dan pengujian tersedia untuk umum melalui repositori proyek. Pernyataan tersebut juga menyediakan pembagian IRES yang telah diproses dan digunakan dalam studi serta data sumber yang mendasari gambar-gambar dalam makalah. Para penulis menyatakan bahwa tidak ada pembatasan terhadap ketersediaan data.
Rincian tersebut penting untuk perbandingan. Peneliti dapat memeriksa set data dan pembagian yang digunakan, menjalankan ulang evaluasi, serta menguji apakah pilihan pelatihan yang berbeda mengubah hasilnya. Dengan demikian, rilis ini mendukung pemeriksaan temuan sekaligus penggunaan ulang model.
Tim dan linimasa publikasi
Penelitian ini dipimpin melalui School of Biomedical Engineering USTC dan laboratorium Medical Imaging, Robotics, Analytic Computing and Learning, yang dikenal sebagai MIRACLE. Para penulis mencantumkan afiliasi di Hefei dan USTC Suzhou Institute for Advanced Research. Penulis pendamping Ruifeng Li berafiliasi dengan College of Computer Science and Technology di Zhejiang University, Hangzhou.
Zhou, seorang profesor, dan Xiong, peneliti senior khusus, menggagas dan mengawasi studi ini. Zhu merancang dan menerapkan kerangka kerja, menjalankan prapelatihan serta sejumlah eksperimen prediksi struktur dan klasifikasi RNA, lalu menganalisis hasilnya. Anggota tim lainnya mengerjakan pengujian homologi, perbandingan set data, identifikasi IRES, dan evaluasi struktural.
Publikasi dan penyampaian hasil penelitian kepada publik berlangsung pada dua tanggal kalender:
- 4 November 2026: Nature mencatat publikasi An open structure-guided RNA foundation model for generalizable prediction.
- 5 November 2026: Penelitian dan rilis terbukanya dipublikasikan di China, dengan keterangan bahwa publikasi daring muncul pada dini hari.
Para penulis melaporkan dukungan dari National Natural Science Foundation of China, National Key R&D Program, program penelitian di Jiangsu dan Suzhou, serta Sanming Project of Medicine di Shenzhen. Mereka menyatakan tidak memiliki konflik kepentingan.
Dampak hasil penelitian terhadap riset RNA
structRFM menyediakan titik awal bersama bagi sejumlah kegiatan penelitian. Laboratorium yang meneliti pemrosesan RNA dapat mengadaptasi model dasar yang sama dengan kelompok lain yang mempelajari pelipatan atau mengklasifikasikan molekul nonpengode. Setiap penerapan tetap membutuhkan pengembangan dan evaluasi tersendiri sesuai tugasnya.
Gabungan 21 juta pasang data pelatihan, pembelajaran terpandu struktur, dan pos pemeriksaan model yang dirilis memberi peneliti sistem konkret untuk diperiksa, bukan sekadar uraian algoritma. MUSES dan eksperimen masking juga menawarkan pilihan desain spesifik yang dapat diuji atau diubah oleh tim lain.
Temuan yang dilaporkan berfokus pada prediksi dan klasifikasi komputasional. Pengembangan menuju penerapan biomedis akan membutuhkan eksperimen biologis lebih lanjut, termasuk memeriksa struktur yang diprediksi dan menguji fungsi yang dikaitkan dengan molekul RNA tertentu.
Makalah tersebut tidak memberikan jadwal penerapan klinis. Perubahan langsungnya adalah akses: peneliti di seluruh dunia dapat memperoleh sumber daya pelatihan, memeriksa implementasi, dan menyelidiki apakah peningkatan yang dilaporkan juga berlaku pada set data RNA mereka sendiri.
Poin Utama
- Peneliti USTC merilis structRFM, model fondasi RNA yang dilatih menggunakan sekitar 21 juta pasang sekuens dan struktur sekunder.
- Model ini mempelajari pola sekuens dan hubungan pasangan basa, lalu menghasilkan fitur hanya dengan masukan sekuens.
- MUSES menggabungkan sumber prediksi struktural, sementara masking dinamis menyeimbangkan informasi struktural dan nukleotida selama pelatihan.
- Para penulis melaporkan hasil kuat dalam klasifikasi homologi dan peningkatan prediksi struktur sekunder, termasuk pengujian pada famili RNA yang baru dirilis.
- Zfold, adaptasi untuk prediksi struktur tersier, mencapai kinerja yang disebut sebanding dengan AlphaFold3 pada tiga kumpulan tolok ukur yang disebutkan.
- Set data, bobot model, kode sumber, dan sumber daya evaluasi tersedia untuk umum agar dapat digunakan kembali dan direproduksi.