Pembuat Ponsel yang Baru Saja Mengubah Inferensi AI
Pada Senin pagi yang mengejutkan industri teknologi, Xiaomi melakukan sesuatu yang tidak diduga banyak pengamat. Perusahaan yang paling dikenal lewat ponsel pintar terjangkau, skuter listrik, dan pemurni udara rumah ini mengumumkan bahwa mereka telah menembus batas besar dalam kecepatan kecerdasan buatan. Mode layanan MiMo-V2.5-Pro-UltraSpeed terbaru menghasilkan lebih dari 1.000 token per detik pada model berparameter satu triliun, dengan kecepatan puncak mendekati 1.200 token dalam demonstrasi langsung. Ini bukan versi model yang dipangkas. Ini adalah MiMo-V2.5-Pro unggulan versi penuh, sistem AI kelas terdepan yang menyaingi Claude Opus dalam tolok ukur pemrograman.
Daftar Isi
- Pembuat Ponsel yang Baru Saja Mengubah Inferensi AI
- Makna Sebenarnya dari 1.000 Token per Detik
- Bagaimana Xiaomi Melampaui Raksasa Chip Khusus
- Tiga Teknik di Balik UltraSpeed
- Mengapa Kecepatan Membuka Berbagai Aplikasi Baru
- Akses, Harga, dan Rilis Sumber Terbuka
- Kebangkitan Xiaomi sebagai Kekuatan AI yang Tak Banyak Disorot
- Sekilas
Yang membuat pengumuman ini mencengangkan bukan hanya kecepatannya, tetapi juga perangkat keras yang menghasilkannya. Xiaomi mencapai angka tersebut dengan satu node standar yang dilengkapi delapan GPU komoditas, jenis perangkat yang tersedia dari penyedia cloud besar mana pun. Tanpa silikon khusus. Tanpa chip spesialis seukuran piring makan. Hanya inovasi perangkat lunak yang berjalan pada perangkat keras yang bisa disewa pengembang malam ini.
Parameter adalah bobot numerik internal yang menentukan cara model AI memproses informasi. Satu triliun parameter berarti model dapat mengenali pola yang sangat kompleks dalam teks dan kode. Token adalah potongan teks yang dibaca dan ditulis model, kira-kira setara dengan tiga perempat kata. Menghasilkan lebih dari 1.000 token per detik berarti otak berskala besar ini beroperasi dengan kecepatan yang sebelumnya dianggap mustahil tanpa perangkat keras khusus.
Selama bertahun-tahun, persaingan untuk mempercepat inferensi AI didominasi perusahaan rintisan chip bermodal besar dengan rancangan silikon khusus. Xiaomi baru saja membuktikan bahwa rekayasa cerdas pada perangkat standar dapat melampaui mereka semua. Pencapaian ini memunculkan pertanyaan penting: apakah perangkat keras khusus yang mahal memang diperlukan jika optimasi perangkat lunak yang cerdas dapat memberikan hasil lebih baik pada infrastruktur yang mudah diakses?
Makna Sebenarnya dari 1.000 Token per Detik
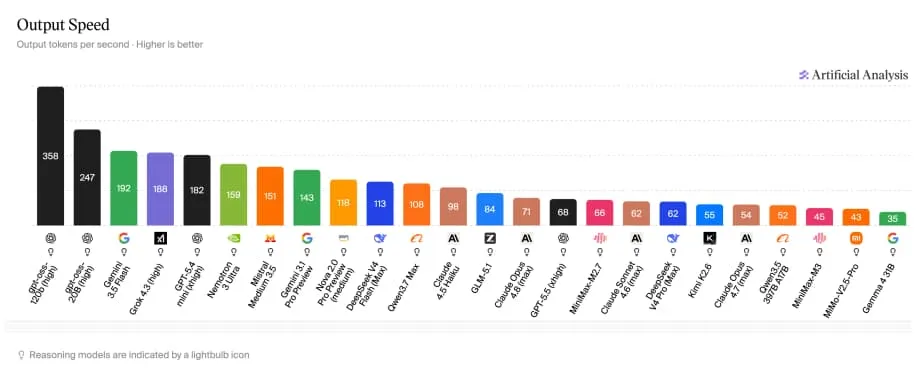
Untuk memahami pentingnya angka ini, lihat pengalaman pengguna sehari-hari saat ini. Menurut data tolok ukur dari Artificial Analysis, GPT-5.5, model yang menggerakkan sebagian besar percakapan ChatGPT, menghasilkan sekitar 68 token per detik. Claude Opus 4.6 beroperasi pada sekitar 71 token per detik, sedangkan model Haiku Anthropic yang lebih ringan mencapai 98 token per detik. Gemini Flash dari Google lebih cepat, yakni 192 token per detik. MiMo-V2.5-Pro-UltraSpeed mencapai 1.000 token per detik pada model berparameter satu triliun, hampir 15 kali lebih cepat daripada chatbot yang digunakan jutaan orang setiap hari.
Perbedaan antara 68 dan 1.000 bukan sekadar peningkatan bertahap. Angka itu menunjukkan kategori kinerja yang sama sekali berbeda. Dengan kecepatan konsumen saat ini, pengguna menunggu beberapa detik hingga satu paragraf teks muncul. Pada kecepatan baru Xiaomi, satu halaman analisis dapat muncul hampir seketika. Bagi pengembang yang menjalankan agen pemrograman, perbedaan ini mengubah pengalaman dari percakapan bolak-balik yang tertunda menjadi sesuatu yang menyerupai kolaborasi waktu nyata.
Token adalah satuan dasar model bahasa besar. Saat Anda mengetikkan prompt, model memecah teks menjadi token untuk diproses. Ketika menjawab, model menghasilkan token satu per satu dengan memprediksi masing-masing berdasarkan semua yang telah muncul sebelumnya. Semakin cepat model menghasilkan token, semakin responsif rasanya dan semakin banyak tugas yang dapat diselesaikan dalam batas waktu yang ketat. Kecepatan juga menentukan jumlah permintaan yang dapat ditangani server secara bersamaan, sehingga berdampak langsung pada biaya dan skalabilitas bagi bisnis.
Model Flash MiMo-V2.5-Pro sebelumnya sudah menghasilkan respons dengan kecepatan 150 token per detik, atau sekitar 110 kata per detik, lebih cepat daripada kemampuan manusia membaca atau berbicara. UltraSpeed mendorong batas itu jauh lebih tinggi, menciptakan laju generasi yang melampaui kecepatan kognisi manusia dan memungkinkan alur kerja berbasis mesin yang sebelumnya tidak mungkin dilakukan.
Bagaimana Xiaomi Melampaui Raksasa Chip Khusus
Hambatan kecepatan inferensi AI telah menarik investasi ratusan juta dolar dari perusahaan yang membangun perangkat keras khusus. Cerebras merancang chip berskala wafer seukuran piring makan, dengan memori on-chip 44 GB untuk menghilangkan kendala bandwidth. Rancangan itu mencapai 969 token per detik, pencapaian mengesankan, tetapi pada Llama 3.1 405B milik Meta, model dengan 405 miliar parameter. Ukurannya kurang dari separuh MiMo-V2.5-Pro. Groq membangun arsitektur Unit Pemrosesan Bahasa khusus yang mampu mencapai 300 hingga 750 token per detik, bergantung pada modelnya. Tidak satu pun sistem tersebut berjalan pada perangkat keras cloud standar yang bisa disewa pengembang dari penyedia seperti AWS.
Pendekatan Xiaomi sepenuhnya membalik model itu. Bekerja sama dengan mitra inferensi TileRT, perusahaan mencapai rekor tersebut melalui pendekatan yang disebutnya desain bersama sistem dan model ekstrem, yakni optimasi terkoordinasi terhadap model AI sekaligus mesin perangkat lunak yang melayaninya. Hasilnya adalah model berparameter satu triliun yang berjalan lebih cepat daripada silikon khusus pada GPU komoditas. Jika pengujian independen mengonfirmasi tolok ukur ini, pencapaian tersebut menunjukkan bahwa inovasi perangkat lunak dapat mengatasi keterbatasan perangkat keras yang selama ini dianggap hanya bisa diatasi dengan chip khusus.
Perkembangan ini memiliki dampak ekonomi yang nyata. Silikon khusus membutuhkan belanja modal besar, siklus desain panjang, dan proses manufaktur spesialis. GPU komoditas mendapat manfaat dari skala ekonomi, ketersediaan luas, serta peningkatan berkelanjutan dari NVIDIA dan produsen lainnya. Dengan memecahkan masalah inferensi melalui perangkat lunak, Xiaomi berpotensi mendemokratisasi akses ke kecepatan yang sebelumnya hanya tersedia bagi laboratorium bermodal besar dengan perangkat keras eksklusif.
Peluncuran checkpoint FP4-DFlash di Hugging Face menambah dimensi lain pada upaya demokratisasi ini. Peneliti dan pengembang di seluruh dunia kini dapat memeriksa, menguji, dan mengadaptasi model dasarnya tanpa membeli perangkat keras eksklusif atau mengurus lisensi perusahaan. Validasi komunitas akan menentukan apakah teknik ini dapat diterapkan secara luas pada berbagai model dan penggunaan.
Tiga Teknik di Balik UltraSpeed
Terobosan ini mengandalkan tiga teknik terkoordinasi yang bekerja bersama. Tidak satu pun dapat mencapai rekor kecepatan sendirian, tetapi gabungannya mendongkrak kinerja hingga melampaui ambang 1.000 token.
Teknik pertama adalah kuantisasi FP4. Kebanyakan model besar beroperasi dengan presisi numerik 16 bit atau 8 bit, yang berarti setiap parameter membutuhkan dua byte atau satu byte memori. Xiaomi memampatkan lapisan pakar, yang mencakup sebagian besar dari satu triliun parameter, hingga presisi 4 bit. Ini mengurangi jejak memori dan tekanan bandwidth sehingga data dapat bergerak lebih cepat dalam sistem. Risiko kuantisasi adalah penurunan kualitas, karena presisi yang lebih rendah dapat mengurangi kemampuan penalaran model. Solusi Xiaomi dilakukan secara terarah: hanya lapisan pakar yang dikompresi, sedangkan bagian model lainnya tetap menggunakan presisi penuh. Perusahaan menyebut penurunan kualitas yang dihasilkan nyaris nol.
Teknik kedua adalah decoding spekulatif DFlash. Decoding spekulatif tradisional menggunakan model draf yang lebih kecil untuk menebak beberapa token berikutnya dengan cepat, lalu model besar memverifikasi tebakan itu secara paralel. DFlash sepenuhnya menghilangkan tahap penyusunan draf yang berurutan. Sebaliknya, teknik ini mengisi satu blok penuh posisi bertopeng dalam satu proses forward. Dalam tugas pemrograman, model besar menerima rata-rata 6,3 dari 8 token yang diajukan pada setiap putaran verifikasi. Artinya, enam token maju dalam satu langkah, bukan satu, sehingga kecepatan generasi meningkat drastis.
Komponen ketiga adalah TileRT, mesin inferensi yang menjaga seluruh alur komputasi tetap berada di dalam GPU. Sistem layanan standar sering menjalankan operator satu per satu sehingga menimbulkan jeda kecil dalam eksekusi. TileRT menghilangkan overhead peluncuran per operator dan menjaga aliran data tetap lancar tanpa jeda. Saat dipadukan dengan bobot model yang telah dikompresi dan strategi decoding canggih, mesin ini mempertahankan tingkat throughput yang sebelumnya tidak dapat dicapai pada perangkat keras standar.
Xiaomi menyebut kombinasi ini desain bersama sistem dan model ekstrem, dan sebutan itu memang tepat. Setiap lapisan optimasi memperkuat lapisan lainnya sehingga menghasilkan kinerja gabungan yang melampaui kemampuan tiap teknik jika digunakan sendiri.
Mengapa Kecepatan Membuka Berbagai Aplikasi Baru
Tolok ukur mentah tidak berarti apa-apa jika tidak memungkinkan sesuatu yang baru. Dengan kecepatan 1.000 token per detik, MiMo-V2.5-Pro-UltraSpeed membuka peluang yang masih tertutup bagi sistem lebih lambat.
Pertimbangkan cara pengembang menggunakan model bahasa besar untuk tugas kompleks saat ini. Ketika menghadapi masalah pemrograman yang sulit, pengguna biasanya menunggu satu jawaban dan berharap jawaban itu benar. Dengan UltraSpeed, pengguna yang sama dapat menjalankan puluhan jalur penalaran secara paralel dalam rentang waktu nyata yang sama, sembari melakukan verifikasi otomatis dan koreksi mandiri di latar belakang. Model dapat menjajaki beberapa solusi secara bersamaan, alih-alih berkomitmen pada satu rangkaian pemikiran. Kemampuan ini mengubah AI secara mendasar, dari asisten yang bekerja berurutan menjadi pemecah masalah paralel.
Industri dengan batas latensi ketat akan segera merasakan manfaatnya. Sistem deteksi penipuan harus mengevaluasi transaksi dalam hitungan milidetik. Pembuatan sinyal perdagangan waktu nyata tidak bisa menoleransi penundaan beberapa detik. Siklus agen otonom, ketika sistem AI mengamati, mengambil keputusan, dan bertindak dengan cepat, membutuhkan kecepatan yang tidak dapat diberikan chatbot konsumen. Pada 68 token per detik, aplikasi-aplikasi ini menghadapi hambatan yang menjengkelkan. Pada 1.000 token per detik, aplikasi tersebut menjadi layak dijalankan di infrastruktur cloud standar.
Bahkan dalam alur kerja pemrograman sehari-hari, kecepatan ini mengubah pengalaman. Sebelumnya, pengembang menatap layar sambil menunggu inferensi selesai. Dengan keluaran yang mendekati dan melampaui 1.000 token per detik, penundaan praktis menghilang. Interaksi bergeser dari meminta dan menunggu menjadi kolaborasi waktu nyata dengan mitra AI. Aplikasi kesehatan yang membutuhkan analisis cepat atas data pasien dan platform investasi yang memproses data pasar langsung sama-sama mendapat manfaat praktis langsung dari tingkat responsivitas ini.
Akses, Harga, dan Rilis Sumber Terbuka
Xiaomi tidak mengunci teknologi ini dari publik. Perusahaan telah meluncurkan uji coba API terbatas yang berlangsung dari 9 hingga 23 Juni 2026. Akses diberikan melalui permohonan dan persetujuan tidak dijamin. Prioritas diberikan kepada pengguna perusahaan dan pengembang profesional dengan kebutuhan bisnis yang jelas. Karena sumber daya inferensi berkecepatan tinggi terbatas, setiap akun dapat masuk antrean hingga sepuluh kali sehari, dengan setiap sesi dibatasi maksimal 30 menit. Sesi yang tidak aktif selama lebih dari lima menit akan otomatis dihentikan.
Struktur harga mencerminkan nilai premium dari kecepatan ini. UltraSpeed dibanderol tiga kali tarif standar MiMo-V2.5-Pro, tetapi menawarkan kecepatan generasi sekitar sepuluh kali lipat. Sebagai perbandingan, harga standar MiMo-V2.5-Pro saja sudah jauh lebih murah daripada Claude Opus, yakni sekitar $0,43 per satu juta token masukan dan $0,87 per satu juta token keluaran, dibandingkan dengan Opus yang mematok $5 untuk token masukan dan $25 untuk token keluaran per satu juta token. Bahkan dengan tarif tiga kali lipat, layanan akselerasi Xiaomi tetap jauh lebih murah daripada banyak model terdepan pesaing.
Bagi pengembang yang ingin menguji teknologi ini secara langsung, Xiaomi telah merilis checkpoint MiMo-V2.5-Pro-FP4-DFlash yang mendasarinya sebagai sumber terbuka di Hugging Face. TileRT juga telah merilis modul-modul tertentu di GitHub. Langkah ini mengundang komunitas peneliti global untuk memverifikasi tolok ukur, bereksperimen dengan arsitekturnya, dan berpotensi mengadaptasi teknik tersebut untuk model lain. Verifikasi independen dari pihak ketiga belum banyak dipublikasikan, sehingga pengujian komunitas melalui rilis terbuka ini akan menjadi pembuktian nyata dalam beberapa pekan mendatang.
Kebangkitan Xiaomi sebagai Kekuatan AI yang Tak Banyak Disorot
Bagi kebanyakan konsumen, Xiaomi tetap dikenal sebagai merek yang menjual perangkat elektronik terjangkau. Perusahaan telah menjual jutaan ponsel pintar, skuter listrik, dan pemurni udara di berbagai pasar global. Citra konsumennya menutupi divisi kecerdasan buatan yang terus berkembang, tetapi nyaris diabaikan industri hingga kini.
MiMo-V2.5-Pro telah menyamai Claude Opus dalam sebagian besar tolok ukur pemrograman sejak diluncurkan pada April. UltraSpeed bukan model baru atau versi yang kemampuannya dikurangi. Teknologi ini mempercepat kecerdasan kelas terdepan yang sama, yang sebelumnya sudah bersaing di jajaran teratas. Merek ponsel ini pada dasarnya telah membangun kemampuan AI yang menyaingi laboratorium khusus, sembari mempertahankan harga yang jauh lebih rendah hingga satu orde besaran.
Jika klaim kecepatannya bertahan dalam pemeriksaan independen, Xiaomi akan mencapai sesuatu yang luar biasa tanpa investasi silikon khusus ratusan juta dolar seperti yang dibutuhkan perusahaan semacam Cerebras dan Groq. Xiaomi akan membuktikan bahwa optimasi perangkat lunak pada perangkat keras komoditas dapat menghasilkan kinerja terdepan di kelasnya. Hasil tersebut akan mengubah asumsi tentang sumber kemampuan AI dan pihak-pihak yang dapat bersaing di garis depan. Raksasa elektronik konsumen dari Beijing kini bergabung dengan jajaran teratas inovator infrastruktur AI, dengan membawa GPU standar alih-alih silikon khusus.
Sekilas
- MiMo-V2.5-Pro-UltraSpeed dari Xiaomi menghasilkan lebih dari 1.000 token per detik pada model berparameter satu triliun dengan hanya menggunakan delapan GPU komoditas standar, tanpa silikon khusus.
- Kecepatannya sekitar 15 kali lebih tinggi daripada GPT-5.5 dan Claude Opus, berkat kuantisasi FP4, decoding spekulatif DFlash, dan mesin inferensi TileRT.
- Uji coba API terbatas berlangsung dari 9 hingga 23 Juni 2026. Tarifnya tiga kali harga standar MiMo dengan kecepatan generasi sekitar sepuluh kali lipat, dan prioritas diberikan kepada pengembang perusahaan dan profesional.
- Xiaomi telah merilis checkpoint FP4-DFlash sebagai sumber terbuka di Hugging Face sehingga komunitas dapat memverifikasi dan mengadaptasi tekniknya.
- Jika terverifikasi secara independen, terobosan ini menunjukkan bahwa optimasi perangkat lunak pada perangkat keras cloud standar dapat mengungguli solusi chip khusus yang mahal dari perusahaan perangkat keras AI spesialis.